OpenAI의 Whisper는 음성을 독특한 방식으로 텍스트로 변환하는 데 도움이 되는 새로운 AI 기반 솔루션입니다. 무엇보다도 무료입니다.
하지만 비교적 사소한 문제가 하나 있습니다. 표준 Windows 도구보다 설치 및 사용이 더 어렵다는 점입니다. 특히 Nvidia 그래픽 카드의 Tensor 코어를 사용하여 성능을 높이려는 경우 더욱 그렇습니다. 확인해 보세요. 당신의 글을 바탕으로 무료로 예술적 이미지를 만들어내는 최고의 AI 기반 도구.
하지만 걱정하지 마세요. 저희가 여기 있는 이유니까요! 설치 및 사용 방법을 알아보려면 계속 읽어보세요. 또한, Nvidia 그래픽 카드를 사용 중이시라면 Whisper가 어떻게 활용될 수 있는지도 알려드리겠습니다.
로압 스리유에스
OpenAI의 Whisper란 무엇인가요?
ChatGPT는 사용자들 사이에서 빠르게 인기를 얻었으며, 여러분이 이를 어떻게 사용할 수 있는지 이미 살펴보았습니다. OpenAI의 ChatGPT하지만 OpenAI의 흥미로운 프로젝트는 이것뿐만이 아닙니다.
딥 러닝과 신경망으로 구동되는 Whisper는 음성을 "이해"하여 텍스트로 변환할 수 있는 자연어 처리 시스템입니다. 또한, 다음과 같은 여러 가지 맞춤형 구성을 제공하여 유사 솔루션보다 우수한 성능을 제공합니다.
- 위스퍼는 자연어를 위해 "훈련된" AI 솔루션입니다. 따라서 기존 솔루션보다 "자연스러운" 인간의 음성을 더 잘 이해합니다.
- Whisper에는 인터페이스가 없으며 오디오를 녹음할 수 없습니다. 기존 오디오 파일을 가져와 텍스트 파일로 출력하는 것만 가능합니다.
- "언어 이해" 능력이 뛰어나기 때문에 Whisper는 자동 번역 능력도 최고 수준입니다.
- Whisper는 온라인 서비스가 아니므로 완전히 오프라인에서도 작동할 수 있습니다.
- NVIDIA 그래픽 카드(GTX970 이상)가 있는 경우 Whisper를 "하드웨어 가속 모드"로 실행하여 응답 속도를 높일 수 있습니다.
- 등록, 라이센스 구매 또는 구독 구매가 필요하지 않습니다.
AMD 그래픽 카드가 지원되지 않는 이유는 무엇입니까?
GPU가 단순한 그래픽 출력 이상의 기능을 수행하려면 완전히 프로그래밍 가능한 프로세서로 기능해야 합니다. 이것이 바로 엔비디아가 공식적으로 "병렬 컴퓨팅 플랫폼 및 프로그래밍 모델"인 CUDA 아키텍처를 개발한 이유입니다.
CUDA는 엔비디아의 독점 기술로, 엔비디아 GPU와만 호환됩니다. AMD의 CUDA와 가장 유사한 대안으로는 OpenCL과 Radeon Compute Platform이 있습니다.
CUDA는 다른 대안들에 비해 더 성숙하고, 성능이 뛰어나며, 사용하기 쉬운 것으로 간주됩니다. 따라서 대부분의 개발자는 CUDA만을 사용하며, 이는 애플리케이션이 Nvidia GPU의 하드웨어 기능만을 활용한다는 것을 의미합니다. 여기에는 Whisper도 포함됩니다. 확인해 보세요. Linux에서 AMD 대 NVIDIA 그래픽 카드: 어떤 것을 사용해야 할까?
Whisper 다운로드 및 설치 방법
안타깝게도 Whisper는 다운로드, 설치 및 정상적으로 실행할 수 있는 독립형 애플리케이션이 아닙니다. Whisper를 사용하려면 다른 종속성도 함께 설치해야 합니다.
Windows의 경우, 이 가이드를 간단하게 설명하기 위해 널리 사용되는 Chocolatey를 사용하여 대부분의 필수 애플리케이션 구성 요소를 설치하겠습니다. 가이드는 다음에서 확인하세요. Windows 애플리케이션을 설치하는 가장 빠른 방법 Chocolatey에 대한 자세한 내용은 여기를 참조하세요.
Linux와 Mac 모두 설치 과정은 비슷합니다(Windows 경로 변수와 우리가 만들게 될 편리한 배치 파일을 제외하고).
- Whisper를 설치하고 사용하려면 Python과 PIP 도구를 설치하고 Windows "Path" 변수에 추가해야 합니다. 자세한 내용은 관련 문서를 참조하세요. Windows에 Python PIP를 설치하는 방법 و 맥과 리눅스.
- 설치 FFMPEG Chocolatey에서 다음 명령을 사용합니다.
choco install ffmpeg
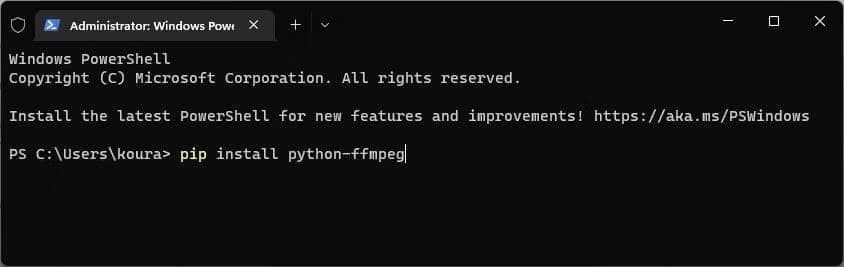
- 또한, 다음을 사용하여 Python 버전을 설치하세요.
pip3 install python-ffmpeg
- 마지막으로, 다음을 사용하여 Github 페이지에서 Whisper를 설치합니다.
pip3 install git+https://github.com/openai/whisper.git
CUDA 지원 버전의 Whisper를 받으세요
Whisper는 주로 Nvidia GPU를 사용하지 않지만, 기반이 되는 Torch 패키지는 CUDA 가속 버전을 제공합니다. Whisper의 "일반" 버전 대신 이 버전을 사용하면 Nvidia 그래픽 카드를 활용하여 필사 작업을 더 빠르게 완료할 수 있습니다.
Nvidia의 CUDA를 사용하는 Whisper를 얻으려면:
- Torch의 바닐라 버전이 이미 설치되어 있는 경우 다음을 사용하여 제거하고 남아 있는 파일을 제거하세요.
pip3 제거 torch
- 이 작업이 끝나면 다음 명령을 입력하세요.
pip 캐시 제거
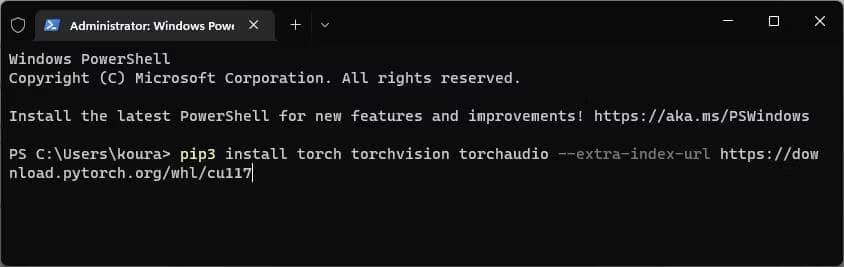
- 다음 명령을 사용하여 Torch의 CUDA 지원 버전을 설치하세요.
pip3 install torch torchvision torchaudio — extra-index-url https://download.pytorch.org/whl/cu117
- Whisper가 Nvidia GPU를 사용할 수 있는지 확인하려면 다음을 사용하세요.
속삭임 — 도움말 | findstr -i pytorch
(기본값: cpu) 대신 (기본값: cuda)가 표시되어야 합니다. 확인하세요. ChatGPT가 당신의 콘텐츠 작성 작업을 맡지 못하는 5가지 이유.
Torch 설치에 실패하면 어떻게 해야 하나요?
Torch를 설치하는 동안 "버전을 찾을 수 없습니다" 오류가 발생하는 경우 현재 버전과 동일한 이전 버전의 Python을 설치해야 할 수 있습니다.
이를 위해 다음 명령을 사용하세요.
choco install python — version OLDER_VERSION — side-by-side
"OLDER_VERSION"을 3.10과 같은 버전으로 바꾸세요.
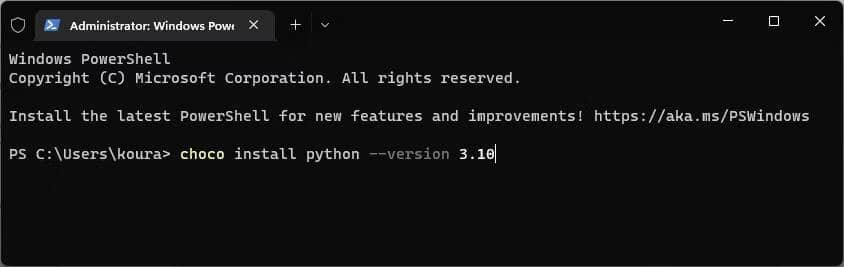
다음으로 모든 "일반" Whisper 명령에 대해 보조 버전 경로를 사용합니다(예: "c:\Python310\Scripts\pip.exe"단순히 "삐"라고 하는 대신).
음성을 녹음하는 방법
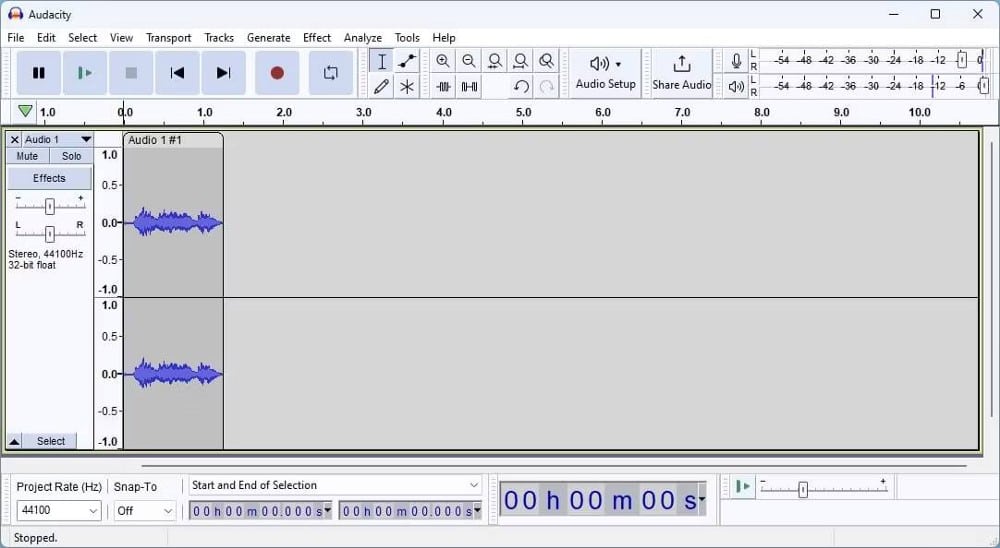
모든 오디오 녹음 애플리케이션을 사용하여 음성을 WAV 또는 MP3 파일로 변환할 수 있습니다. Windows에는 이러한 애플리케이션이 포함되어 있습니다. 자세한 내용은 사용 방법을 참조하세요. Windows 10의 음성 녹음기 앱.
모든 기능을 갖춘 옵션을 원하시면 Audacity를 사용해 보세요. 자세한 내용은 가이드를 참조하세요. Audacity 사용 방법 Windows와 Mac에서 오디오를 녹음합니다.
Whisper로 글쓰기를 시작하는 방법
Whisper는 간단한 그래픽 사용자 인터페이스를 갖추고 있지는 않지만 사용하기 매우 편리합니다.
그리스어 연설이 담긴 LatestNote.mp3 파일이 c:\MyAudioFiles 폴더에 있다고 가정해 보겠습니다. 그리고 이를 영어로 번역하여 텍스트 파일에 복사하려고 합니다.
- 우리는 달리기 시작한다 명령 프롬프트 또는 PowerShell.
- 다음 명령을 사용하여 오디오 파일이 저장된 위치로 "디렉토리를 변경"합니다.
cd C:\MyAudioFiles
- 다음을 사용하여 파일에서 Whisper를 실행합니다.
속삭임 — 모델 기반 — 언어 gr — 작업 번역 LatestNote.mp3
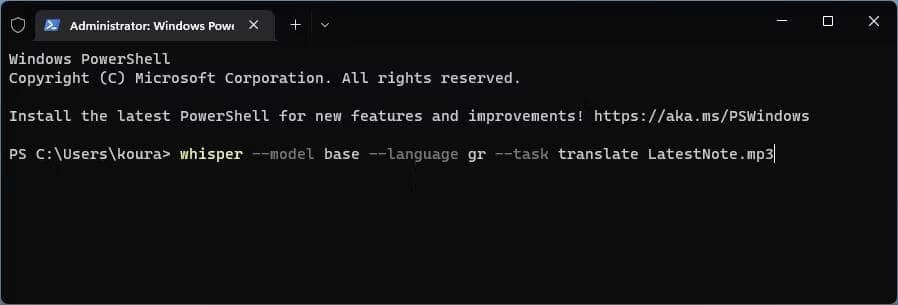
처리가 완료되면 "LatestNote.mp3.txt"라는 텍스트 파일이 같은 폴더에 나타납니다. 메모장과 같은 텍스트 편집기에서 파일을 열어 번역된 텍스트를 확인하세요.
영어 표기가 더 간단하기 때문에 예시 번역을 사용했습니다. "lose", "-language", "-task" 태그만 사용하면 됩니다. 따라서 간단한 표기의 경우 위 명령어는 다음과 같습니다.
속삭임 — 모델 기반 LatestNote.mp3
Whisper는 여러 옵션 중 하나를 사용하므로 "모델" 태그가 필요합니다. 필요에 맞는 최적의 옵션을 선택하는 데 도움이 되도록 자세히 설명해 드리겠습니다. 확인해 보세요. 오디오 필사의 기능은 무엇인가요? 어떤 역할을 하며 어떻게 작동하나요?
어떤 모델을 선택하시겠습니까?
Whisper는 다양한 언어 모델을 제공합니다. 모델이 클수록 정확도는 높아지지만 하드웨어 요구 사항도 높아집니다. 이러한 모델은 다음과 같습니다.
- 작은.
- 자료.
- 작은.
- 매체입니다.
- 큰.
대부분의 영어 사용자에게는 소형 또는 기본 모델이 적합합니다. 영어가 모국어가 아닌 사용자는 중형 및 대형과 같은 대형 모델이 더 나은 결과를 제공할 수 있습니다.
그러나 중형 및 대형 모델에는 8GB 이상의 VRAM이 필요합니다(즉,그래픽 프로세서의 메모리").
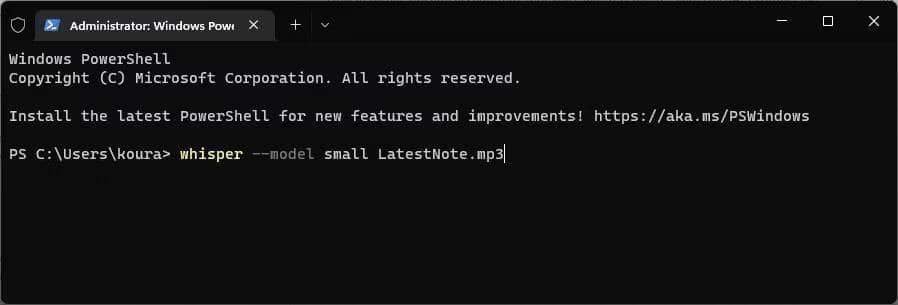
이 중 하나를 지정하려면 명령에서 "—model" 스위치 뒤에 모델을 지정하세요.
속삭임 — 모델 크기: 초소형/중형/대형 [파일]
على سبيل المثال :
속삭임 — 소형 모델 My_Voice_Note.mp3
오디오 필사본을 단순화하는 방법
오디오를 텍스트로 변환할 때마다 Whisper 명령어 전체를 입력해야 하면 금방 지루해질 수 있습니다. 이 과정을 간소화하기 위해 전역적으로 접근 가능한 배치 파일을 만들어 보겠습니다.
- Windows 탐색기를 실행하고 드라이브를 방문하세요. C:.
- 텍스트를 위한 폴더를 만들고, 해당 경로를 클립보드에 복사합니다.
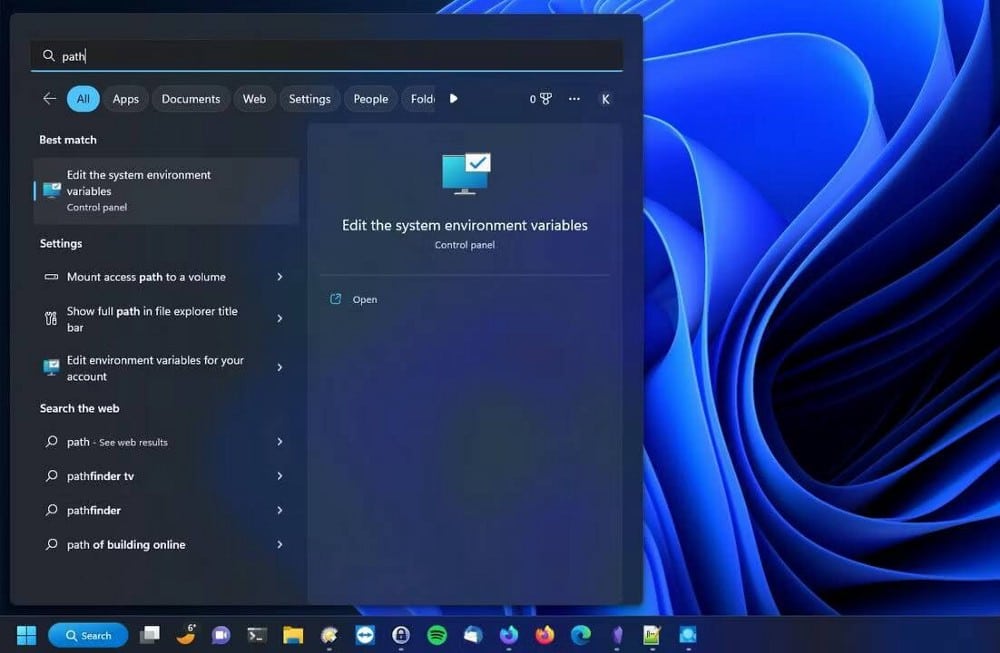
- Windows 시작 메뉴에서 "경로"를 검색하고 선택하십시오. 시스템 환경 변수 수정.
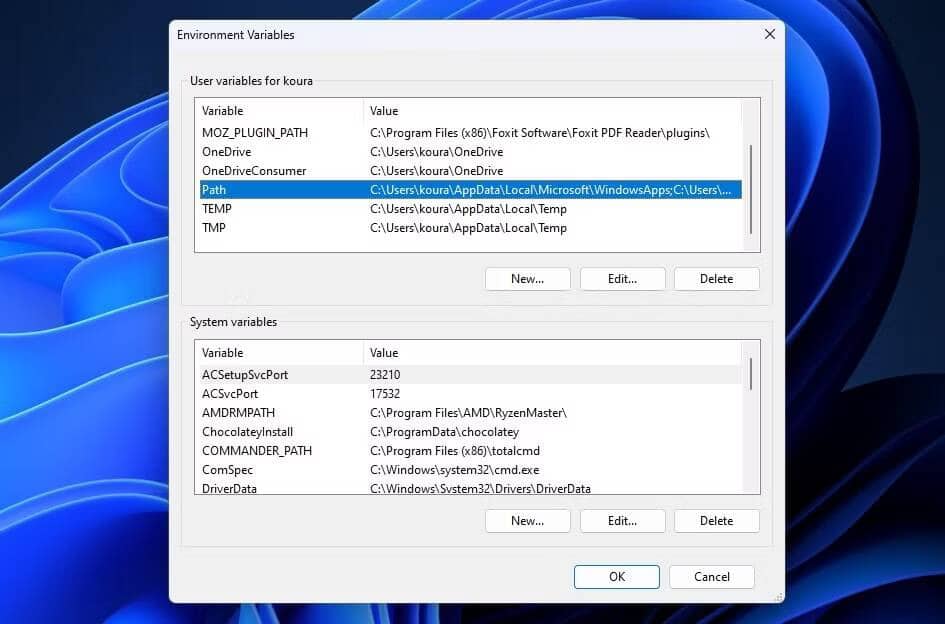
- 찾다 경로 변경자 사용자 변수에서 YOUR_USERNAME을 선택하세요. 두 번 클릭하여 편집하세요. جديد 스크립트 폴더 경로를 붙여넣으세요. '확인'을 클릭하여 변경 사항을 적용하세요.
- Windows 탐색기의 스크립트 폴더로 돌아가세요. "wht.bat"라는 이름의 새 배치 파일을 만들고, 그 안에 다음 명령을 추가하세요.
속삭임 — 작은 모델 — 언어 %1
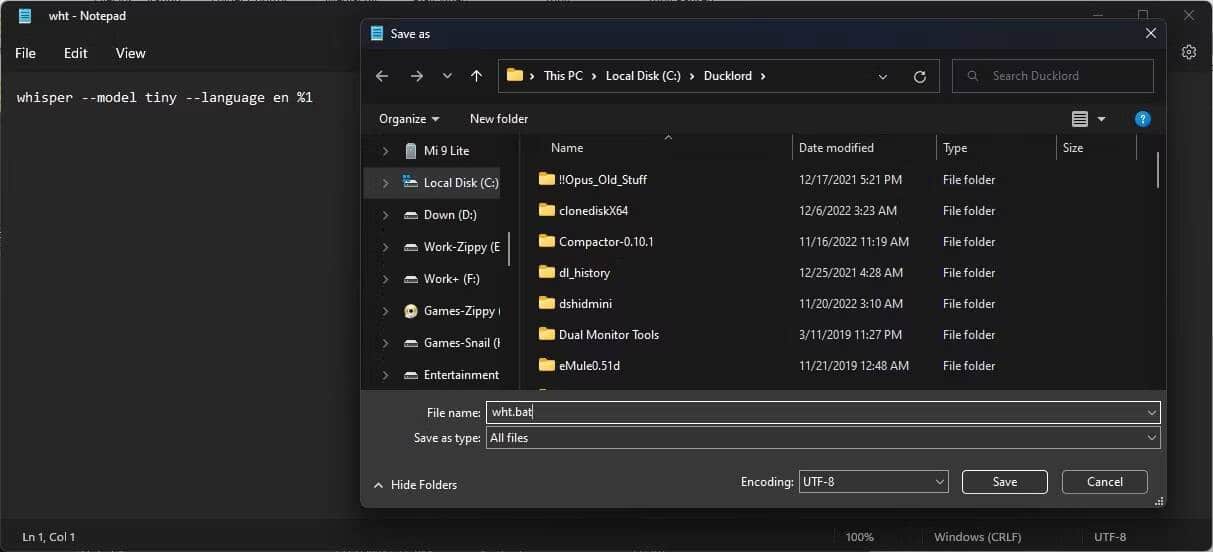
- "whs"와 "whm"이라는 두 개의 배치 파일을 만듭니다.
- 첫 번째 파일에 다음 명령을 추가하세요:
속삭임 — 소형 모델 — 언어 %1
- 두 번째 파일에 다음 명령을 추가합니다.
속삭임 — 모델 매체 — 언어 %1
축하합니다! 이제 Whisper의 소형, 중형, 기본 모델을 오디오 파일에 쉽게 사용할 수 있는 세 가지 파일이 생겼습니다! 모든 오디오 파일을 텍스트로 변환하세요.
- Windows 파일 탐색기를 사용하여 파일을 찾으세요.
- 빈 공간을 마우스 오른쪽 버튼으로 클릭하고 터미널에서 열기를 선택합니다.
- 소규모 또는 중규모 언어 모델을 사용하려면 "wht"를 "whs" 또는 "whm"으로 바꿔서 다음 명령을 입력하세요.
YOUR_AUDIO_FILE.mp3
Whisper로 오디오 콘텐츠를 빠르게 작성하세요
아무리 타이핑 속도가 빠른 사람이라도 말하는 속도에는 미치지 못합니다. 하지만 얼마 전까지만 해도 타이핑보다 말하는 것이 문서 작성에 더 적합했습니다.
대부분의 음성-텍스트 변환 솔루션은 밋밋한 결과를 보였습니다. 시도해 볼 만한 솔루션도 있었지만, 사용하기 복잡하거나 가격이 비쌌습니다. 다행히 Whisper가 이 모든 것을 바꿔놓았습니다.
위 단계를 마치면 단 하나의 명령만으로 음성을 매우 정확하게 필사하거나 번역할 준비가 됩니다. 이제 다음을 볼 수 있습니다. 노트 작성, 회의 및 강의를 위한 최고의 오디오-텍스트 앱.