오늘날 우리가 사용하는 대부분의 AI 도구는 클라우드 컴퓨팅에서 실행되므로 지속적인 인터넷 연결이 필요합니다. 기기에서 AI 도구를 로컬로 실행할 수 있는 옵션도 있지만, 일반적으로는 강력하고 값비싼 하드웨어가 필요하다는 인식이 있습니다.
저도 그렇게 생각했습니다. 그러다 비교적 오래된 기기(거의 1070년 된 GTX XNUMX 그래픽 카드)에서 네이티브 AI 도구 몇 가지를 테스트해 보기로 했습니다. 그리고 실제로 가능하고 효과적이라는 것을 알게 되었습니다. 이 실험은 사양이 낮은 기기에서도 AI를 사용할 수 있는 새로운 가능성을 열어주었고, 더 많은 사용자가 이 기술을 접할 수 있게 되었습니다.

로압 스리유에스
로컬 AI 챗봇을 사용해야 하는 이유는 무엇입니까?
ChatGPT, Gemini, Claude 등 온라인에서 수많은 AI 기반 챗봇을 사용해 봤습니다. 아주 잘 작동하더군요. 하지만 인터넷에 연결되어 있지 않아도 AI 챗봇을 사용하고 싶을 때는 어떻게 해야 할까요? 아니면 매우 사적인 내용이나 업무상 또는 다른 이유로 공개할 수 없는 정보를 처리해야 할 때는 어떻게 해야 할까요?
이때 모든 대화와 데이터를 기기에 보관하는 로컬 오프라인 대규모 언어 모델(LLM)이 필요합니다. 로컬 AI 챗봇 인터넷 연결에 의존하지 않고 인공지능의 힘을 활용합니다.
개인정보보호가 고려됩니다 대규모 지역 언어 모델을 사용하는 주요 이유 중 하나는 다음과 같습니다.그러나 검열 회피, 오프라인 사용, 비용 절감, 사용자 정의 등과 같은 다른 이유도 있습니다. 로컬 AI 챗봇 귀하의 데이터에 대한 완벽한 제어를 통해 귀하의 민감한 정보가 안전하게 보호됩니다.
양자화된 대규모 언어 모델(양자화된 LLM)이란 무엇입니까?
온프레미스 환경에서 대규모 언어 모델(LLM)을 사용하려는 대부분의 사람들에게 가장 큰 과제는 하드웨어입니다. 가장 강력한 AI 모델은 이를 실행하기 위해 강력한 하드웨어가 필요합니다. 사용 편의성 외에도 하드웨어 제약은 대부분의 AI 기반 챗봇이 클라우드 컴퓨팅을 기반으로 하는 또 다른 이유입니다.
하드웨어 제약 때문에 대용량 언어 모델(LLM)을 네이티브로 실행할 수 없을 거라고 생각했던 것 중 하나였습니다. 요즘 저는 AMD Ryzen 5800x 프로세서(2020년 출시), 32GB DDR4 RAM, 그리고 GTX 1070 GPU(2016년 출시)를 탑재한 비교적 저렴한 PC를 사용하고 있습니다. 최고급 하드웨어는 아니지만, 요즘 게임을 거의 하지 않는다는 점을 고려하면 (그리고 게임을 할 때는 오래되고 리소스 집약도가 낮은 인디 게임) 그리고 최신 GPU의 높은 비용에도 불구하고, 저는 지금 가지고 있는 것에 만족합니다.
하지만 가장 강력한 AI 모델은 필요하지 않다는 것이 밝혀졌습니다. 양자화된 대규모 언어 모델(양자화된 LLM) 이는 특히 소수점이 있는 숫자 등 사용하는 데이터를 단순화하여 더 작고 빠르게 만든 AI 모델입니다.
AI는 일반적으로 고정밀 숫자(예: 32비트 소수)를 사용하는데, 이는 상당한 양의 메모리와 처리 능력을 소모합니다. 양자화는 모델의 동작을 크게 변화시키지 않으면서 이러한 숫자를 저정밀 숫자(예: 8비트 정수)로 줄입니다. 즉, 모델이 더 빠르게 실행되고 저장 공간을 덜 사용하며 스마트폰이나 주변 기기와 같은 더 작은 기기에서도 실행될 수 있습니다. 단, 정확도가 약간 떨어질 수 있습니다.



즉, 내 오래된 하드웨어는 3.1억 개의 매개변수를 가진 Llama 205만큼 강력한 대규모 언어 모델(LLM)을 실행하기에는 확실히 어려움이 있겠지만, 대신 더 작은 8B 양자 모델은 실행할 수 있다는 뜻입니다.
그리고 언제 OpenAI가 발표되었습니다 처음으로 완전히 양자화된 개방형 가중치 추론 모델을 만들었기 때문에, 이제 오래된 하드웨어에서 얼마나 잘 작동하는지 확인할 때가 되었다고 생각했습니다.
Nvidia GTX 1070 그래픽 카드와 LM Studio를 사용하여 로컬로 대규모 언어 모델(LLM)을 사용하려면 어떻게 해야 하나요?
이 섹션을 시작하기에 앞서, 저는 로컬 대규모 언어 모델(LLM)이나 제 컴퓨터에서 이 지능형 모델을 실행하는 데 사용한 소프트웨어 전문가가 아니라는 점을 밝히고 싶습니다. 여기서는 GTX 1070 그래픽 카드에서 스마트 챗봇을 로컬로 실행하기 위해 제가 수행한 작업과 이 솔루션의 효율성을 평가하는 내용만 제시하겠습니다. 클라우드 서비스에 의존하지 않고도 사용 가능한 컴퓨팅 성능을 활용하여 고급 AI 모델을 실행하는 방법을 보여드리는 것이 목표입니다.
LM 스튜디오 다운로드
대규모 언어 모델(LLM)을 로컬에서 실행하려면 특수 소프트웨어가 필요합니다. 특히, LM스튜디오LLM 모델을 기기에 로컬로 다운로드하여 실행할 수 있는 무료 도구입니다. LM Studio 홈페이지로 이동하여 [운영체제]에 대한 다운로드 (저는 Windows 10을 사용합니다.) LM Studio는 다양한 대규모 언어 모델을 실험하고 이를 배포하기 전에 개인용 컴퓨터에서 성능을 평가하고자 하는 개발자와 연구자에게 이상적인 플랫폼입니다.
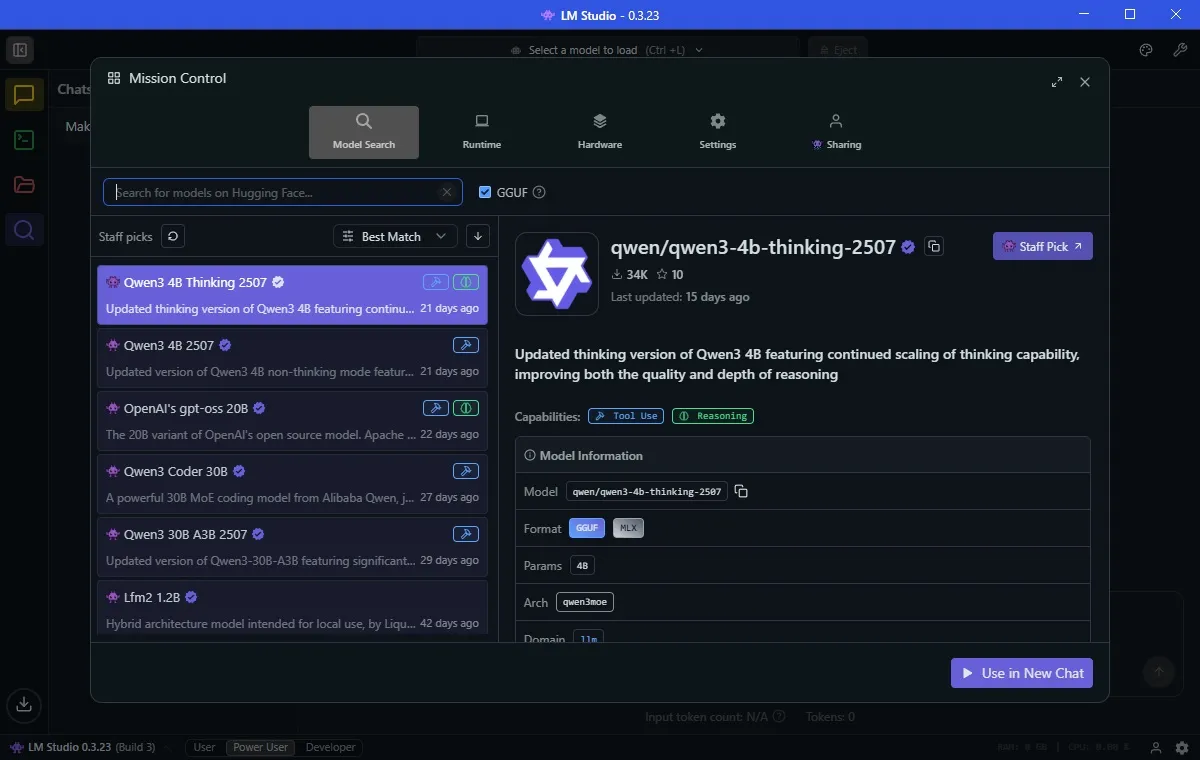
표준 Windows 설치 과정입니다. 설치 프로그램을 실행하고 설치를 완료한 후 LM Studio를 실행하세요. 다음 옵션을 선택하는 것이 좋습니다. 고급 사용자 유용한 옵션들을 살펴볼 수 있기 때문입니다. 이 옵션은 프로그램 설정에 대한 제어력을 높이고 LLM 모델 사용 경험을 맞춤 설정할 수 있는 고급 옵션을 제공합니다. LM Studio를 사용하면 대규모 언어 모델의 세계를 쉽고 효율적으로 탐색할 수 있습니다.
첫 번째 로컬 AI 모델을 다운로드하세요
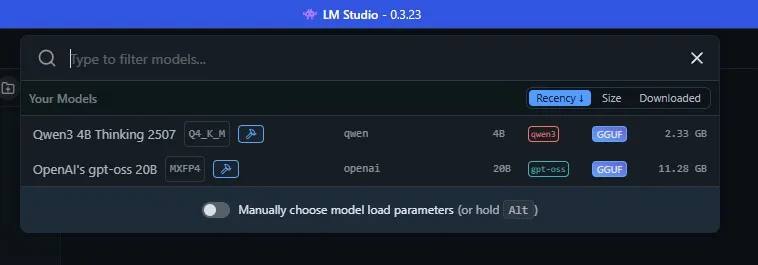
설치 후 첫 번째 대규모 언어 모델(LLM)을 로드할 수 있습니다. 탭을 선택하세요. 발견하다 (돋보기 아이콘). LM Studio는 귀하의 기기에서 가장 잘 작동하는 기본 AI 모델을 쉽게 표시합니다.
내 경우에는 이름이 지정된 템플릿을 다운로드하는 것이 좋습니다. 웬 3-4b-생각-2507모델명은 Qwen(중국 기술 대기업 알리바바가 개발), 이는 이 모델의 세 번째 버전입니다. "4b" 값은 이 모델이 사용자에게 응답하는 데 사용할 수 있는 매개변수가 2507억 개라는 것을 의미하며, "thinking"은 이 모델이 응답하기 전에 답변을 고려하는 데 시간을 할애한다는 것을 의미합니다. 마지막으로, 25은 이 모델이 마지막으로 업데이트된 날짜인 XNUMX월 XNUMX일입니다.
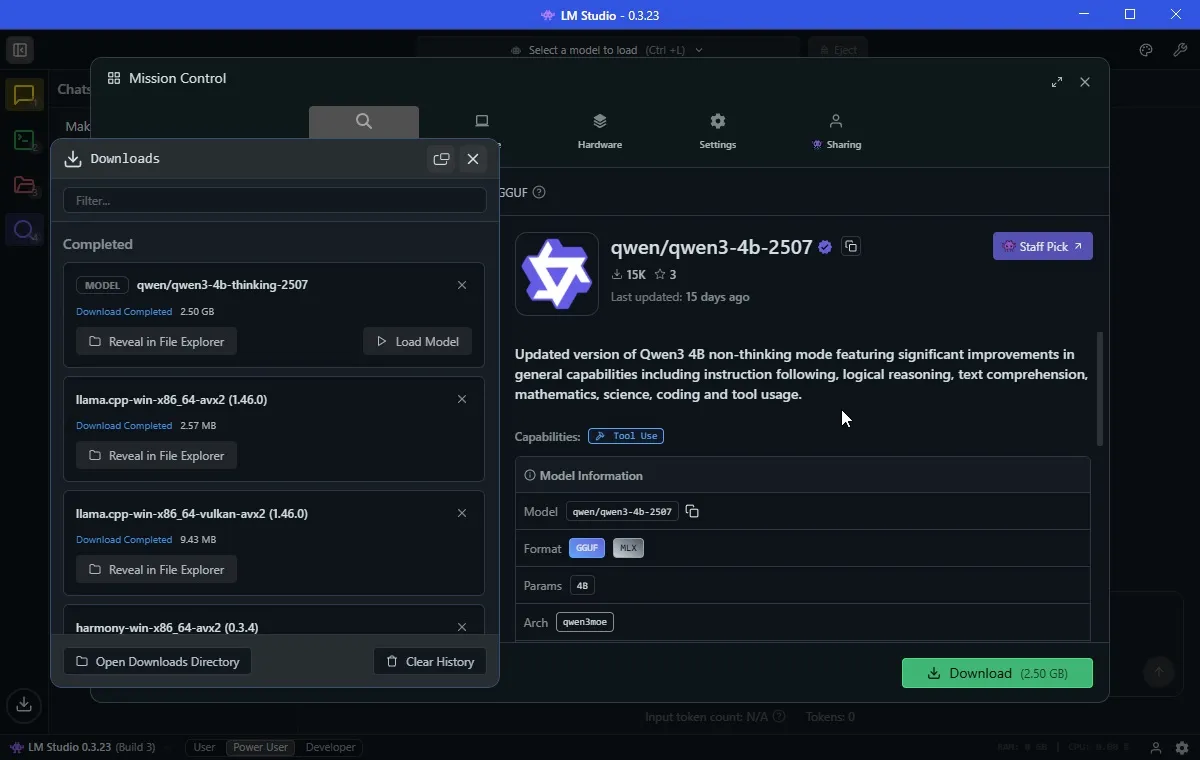
Qwen3-4b-thinking은 용량이 2.5GB에 불과해서 다운로드 시간이 오래 걸리지 않을 겁니다. 이전에 OpenAI/gpt-oss-20b도 다운로드했는데, 용량이 12.11GB로 더 큽니다. 20억 개의 매개변수를 포함하고 있어서 "더 나은" 답변을 제공할 것으로 예상되지만, 리소스 사용량이 더 많아질 수 있습니다.
이제, 별도로 AI 모델 명명의 복잡성LLM을 다운로드하면 사용할 준비가 거의 완료된 것입니다.
AI 모델을 실행하기 전에 탭으로 이동하세요 하드웨어 LM Studio가 시스템을 올바르게 식별하는지 확인하세요. 아래로 스크롤하여 조정할 수도 있습니다. 가드 레일 여기. 내 컴퓨터의 방화벽을 설정했습니다. 균형이 잡힌 자이를 통해 하나의 AI 모델이 너무 많은 리소스를 소비하여 시스템 과부하가 발생하는 것을 방지합니다.
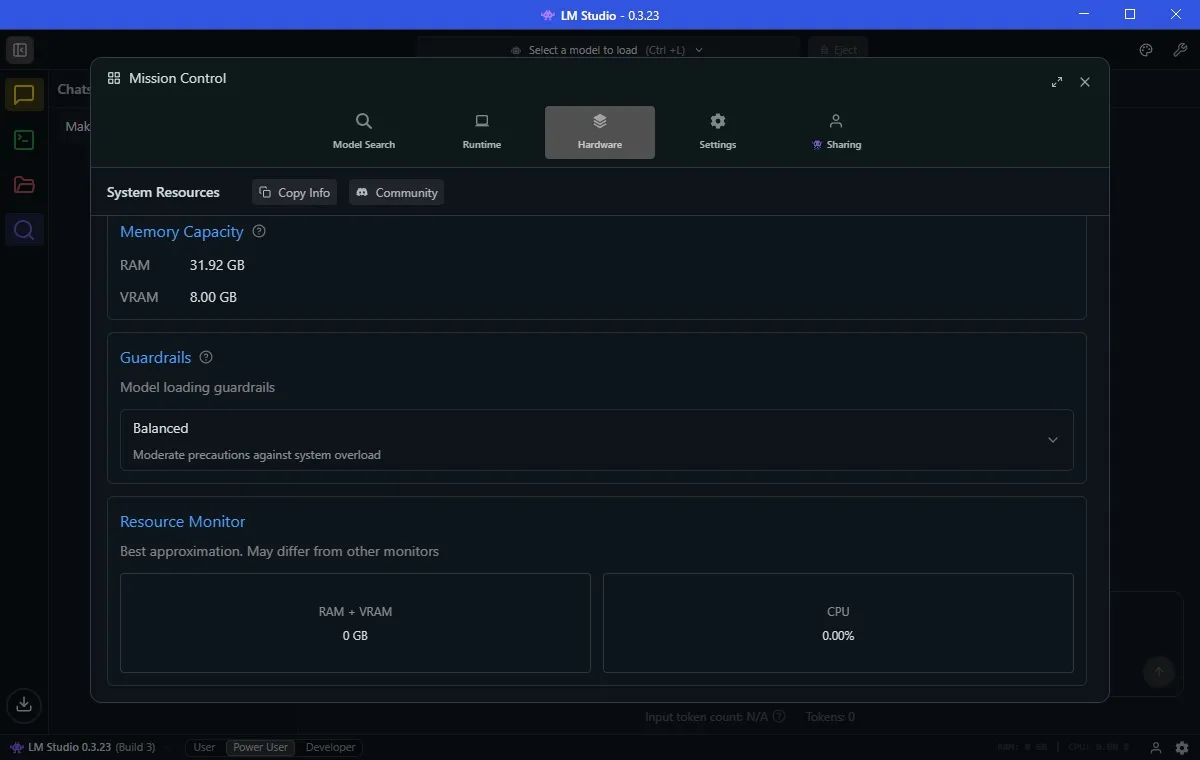
당신은 또한 다음을 알게 될 것입니다 리소스 모니터 가드레일 아래. AI 모델이 시스템 사용량을 얼마나 소모하는지 쉽게 확인할 수 있는 방법입니다. 저처럼 하드웨어 사용량이 제한적인 경우, 시스템이 예기치 않게 중단되는 것을 원치 않으므로 모니터링하는 것이 좋습니다.
AI 모델을 업로드하고 사용을 시작하세요.
이제 기기에서 로컬로 AI 챗봇을 사용할 준비가 되었습니다. LM Studio에서 검색 도구 역할을 하는 상단 바를 선택하세요. AI 이름을 선택하면 AI 모델이 컴퓨터 메모리에 로드되고 명령어와 질문을 입력할 수 있습니다. 이 과정은 대용량 언어 모델(LLM)의 기능을 기기에서 직접 활성화하여 인터넷에 연결하지 않고도 AI를 인터랙티브하고 빠르게 경험할 수 있도록 하는 데 필수적입니다. 모델 성능은 기기 사양에 따라 달라지므로 AI 모델을 효율적으로 실행할 수 있는 충분한 리소스가 있는지 확인하세요.
이전 하드웨어에서 로컬로 AI 모델 실행: 훌륭하지만 제한이 있음
로컬에서 AI 모델을 실행하면 평소처럼 이점을 얻을 수 있지만, 몇 가지 중요한 한계점을 인지해야 합니다. 이러한 로컬 모델은 유용하지만 ChatGPT에 사용되는 GPT-5와 같은 최첨단 모델만큼 강력하지는 않습니다. 또한, 사고 및 응답 프로세스가 훨씬 더 오래 걸리고 응답 품질이 크게 달라질 수 있습니다.
예를 들어, Qwen과 gpt-oss에서 고전적인 대규모 언어 모델(LLM)을 테스트했는데, 두 모델 모두 오랜 대기 시간 끝에 작업을 완료하는 데 성공했습니다. 이는 구형 컴퓨터에서 네이티브 AI 모델을 사용하는 것이 실용적인 해결책이 될 수 있지만, 인내심과 구형 하드웨어의 한계에 대한 이해가 필요하다는 것을 보여줍니다.
앨런, 밥, 콜린, 데이브, 에밀리가 원을 그리며 서 있습니다. 앨런은 밥 바로 왼쪽에 있습니다. 밥은 콜린 바로 왼쪽에 있습니다. 콜린은 데이브 바로 왼쪽에 있습니다. 데이브는 에밀리 바로 왼쪽에 있습니다. 앨런 바로 오른쪽에는 누가 있습니까?
Qwen은 정답에 도달하는 데 5분 11초가 걸렸습니다. GPT-5는 약 45초밖에 걸리지 않았습니다. 하지만 누가 모두를 능가했을까요? 20초라는 기록적인 시간을 기록한 gpt-oss-31b입니다.
한 번의 테스트로는 부족해서 AI 추론 능력을 테스트하도록 설계된 다른 퍼즐에도 적용해 보았습니다. 이전 테스트에서 OpenAI의 최신 모델인 GPT-5가 이 테스트에서 실패했기 때문에, 오프라인 버전의 Qwen과 gpt-oss가 어떻게 처리할지 궁금했습니다.
논리 문제 해결에 있어서 인공지능 모델의 성능 분석
AI 모델에게 논리적 문제를 해결하는 능력은 진정한 과제입니다. 여러 사람 간의 공간적 관계를 파악하는 위의 예시는 이러한 모델의 성능이 얼마나 가변적일 수 있는지를 보여줍니다.
공간 관계와 인공지능의 과제
공간 관계 처리는 인공지능의 핵심 요소로, 언어에 대한 예리한 이해와 논리적 추론 능력을 요구합니다. 앞의 예시는 gpt-oss-20b와 같은 일부 모델이 이 작업에 탁월한 반면, Qwen이나 GPT-5와 같은 다른 모델들은 정확한 해를 도출하는 데 더 오랜 시간이 걸린다는 것을 보여줍니다.
인공지능 평가를 위한 다양한 테스트의 중요성
AI 역량을 종합적으로 평가하기 위해 단일 테스트만으로는 부족합니다. 논리적 추론, 언어 이해, 복잡한 문제 해결 등 지능의 다양한 측면을 포괄하는 다양한 테스트를 수행해야 합니다. 이를 통해 각 모델의 역량과 한계를 더욱 정확하게 평가할 수 있습니다.
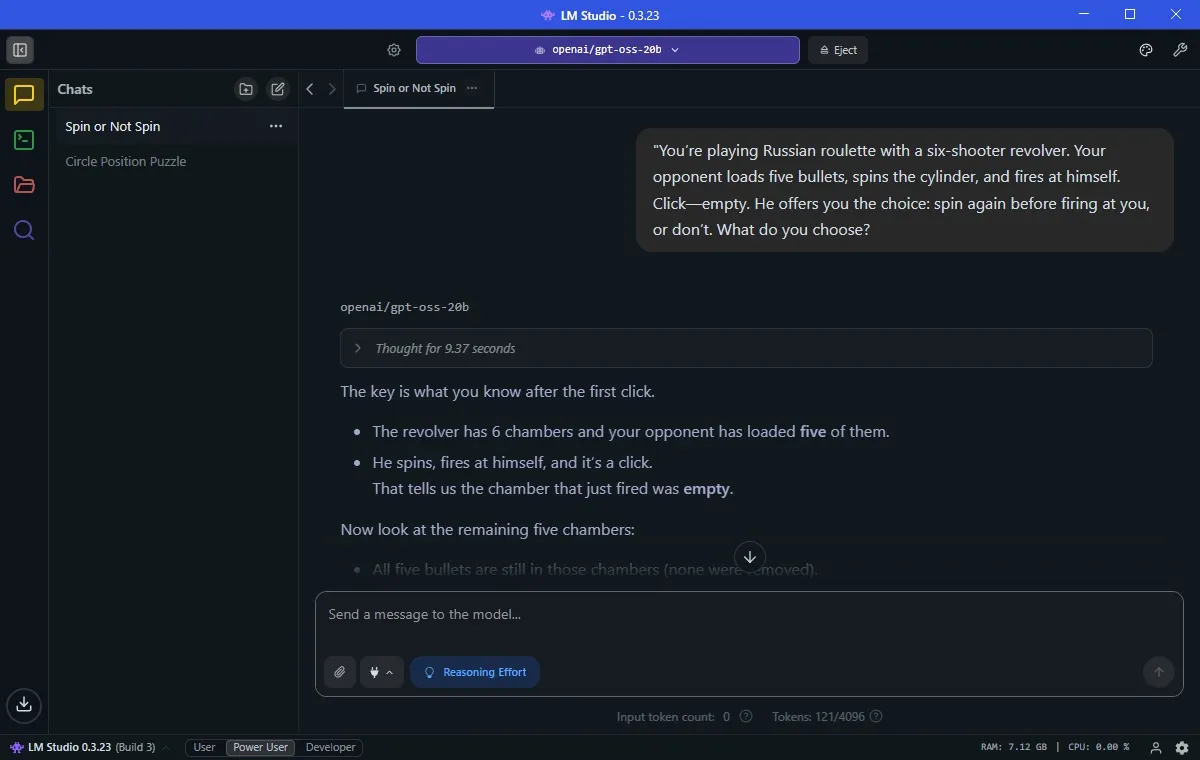
6연발 권총으로 러시안 룰렛을 한다고 상상해 보세요. 상대는 총알 다섯 발을 장전하고 드럼을 돌린 후 스스로 총을 쏴버립니다. "틱"은 총알이 없다는 뜻입니다. 그러면 상대는 당신에게 선택을 제안합니다. 총에 맞기 전에 드럼을 다시 돌릴지, 아니면 돌리지 않을지, 당신은 무엇을 선택하시겠습니까?
Qwen 모델은 41분 5초 만에 정답을 제시했는데, 하드웨어 한계를 고려하면 매우 빠른 시간입니다. 하지만 놀랍게도 GPT-20는 이 문제를 해결하지 못했습니다. 정말 놀랍습니다. 심지어 정답 이유를 보여주는 차트까지 제공해 주겠다고 했습니다. gpt-oss-9b는 다시 한번 단 XNUMX초 만에 정답을 제시했습니다.
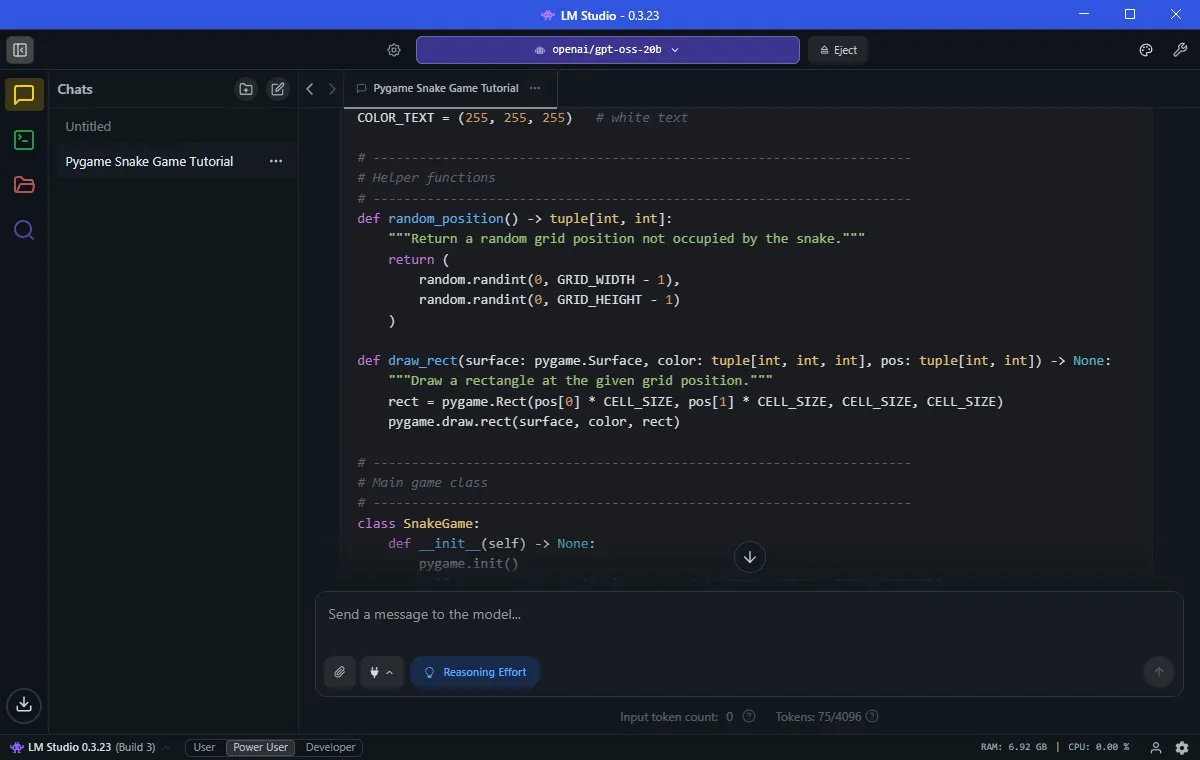
다른 영역에서도 즉각적인 성공을 거두었습니다. gpt-oss에 "Pygame을 사용하여 뱀 게임을 만들어 주세요"라고 요청했더니 1~2분 만에 완벽하게 작동하는 뱀 게임을 만들었습니다. 이는 이 모델이 효율적으로 게임을 생성할 수 있다는 것을 보여줍니다.
기존 기기에서 AI 모델 실행
구형 하드웨어에서 대용량 언어 모델(LLM)을 네이티브로 실행하는 핵심은 하드웨어 성능에 맞는 AI 모델을 선택하는 것입니다. Qwen 버전이 LM Studio에서 좋은 성능을 보였고 최고의 선택이었지만, OpenAI의 gpt-oss-20b 모델은 분명히 훨씬 더 뛰어난 선택입니다.
하지만 기대치의 균형을 맞추는 것이 중요합니다. gpt-oss가 질문에 정확하게 (그리고 GPT-5보다 빠르게) 답변했지만, 엄청난 양의 데이터를 처리할 수는 없을 것입니다. 제 하드웨어의 한계가 곧 드러날 것입니다.
시도하기 전에는 구형 하드웨어에서 네이티브 AI 챗봇을 실행하는 것은 불가능하다고 확신했습니다. 하지만 양자 모델과 LM Studio 같은 도구 덕분에 가능할 뿐만 아니라 놀라울 정도로 유용합니다.
하지만 클라우드에서 GPT-5와 같은 것을 사용할 때와 같은 속도, 정확도, 또는 추론 깊이를 얻을 수는 없습니다. 로컬에서 실행하면 개인 정보 보호, 오프라인 액세스, 데이터 제어 등의 이점을 얻을 수 있지만, 성능은 어느 정도 희생됩니다.
하지만 7년 된 GPU와 4년 된 CPU로도 최신 AI를 처리할 수 있다는 사실은 매우 흥미롭습니다. 고성능 하드웨어가 없어서 망설이신다면 걱정하지 마세요. 로컬 양자 모델이 오프라인 AI로 가는 지름길이 될 수 있습니다. 기존 하드웨어를 최대한 활용하려면 적합한 AI 모델을 사용하세요.