NVIDIA가 인기 있고 다양한 그래픽 카드 라인업으로 병렬 컴퓨팅 분야를 계속 장악하고 있다는 것은 의심의 여지가 없습니다. 하지만 AMD의 Instinct AI 가속기가 최신이자 최대 규모의 슈퍼컴퓨터 두 대(Frontier와 El Capitan)에 탑재되고, 오픈 소스 ROCm 플랫폼에 대한 커뮤니티의 지지가 확대됨에 따라 NVIDIA는 역대 최대 규모의 경쟁자를 만난 셈입니다.
AMD Instinct에 탑재된 AI 가속기는 정확히 무엇일까요? 무엇이 이 가속기를 강력하게 만들며, NVIDIA의 Tensor GPU와 비교하면 어떨까요? 확인해 보세요. AMD 프로세서가 장착된 마더보드와 Intel 프로세서가 장착된 마더보드의 차이점은 무엇입니까?
로압 스리유에스
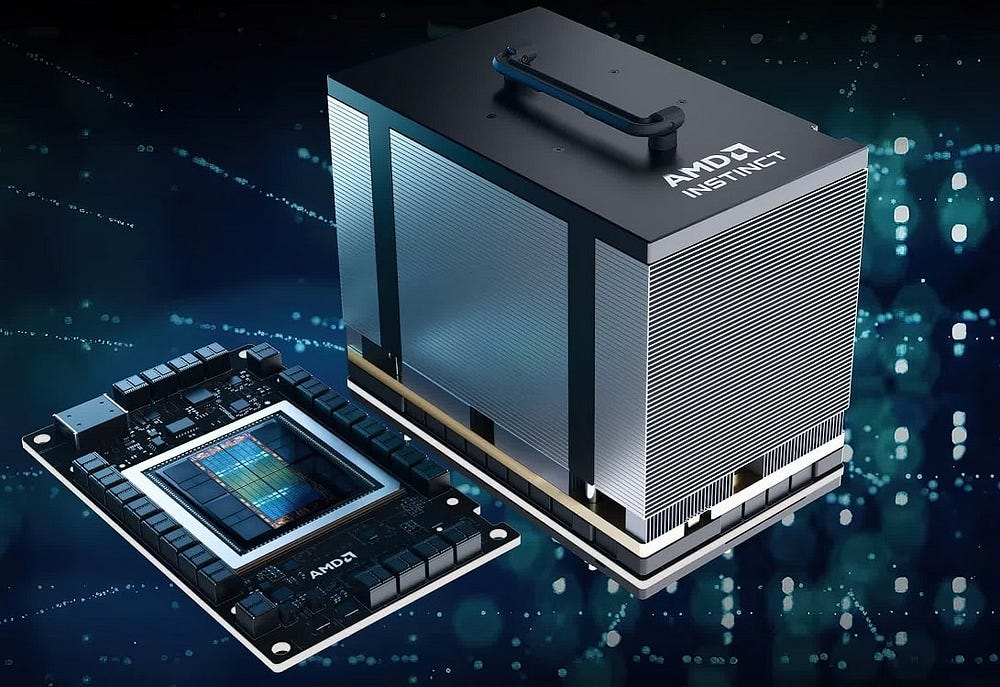
AMD Instinct란 무엇인가요?
AMD Instinct GPU는 고성능 컴퓨팅(HPC) 및 AI 가속 처리에 사용되는 엔터프라이즈급 장치입니다. 일반 소비자용 GPU와 달리, Instinct GPU는 소프트웨어 및 하드웨어 혁신을 통해 AI 학습, 빅데이터 처리 및 기타 고성능 작업을 더욱 효율적으로 처리하도록 설계되었습니다.
AMD의 Instinct 시리즈는 엑사스케일 컴퓨팅의 장벽을 깨는 최초의 슈퍼컴퓨터에 탑재되어 초당 1.1 EFLOP의 배정밀도 연산 성능을 발휘했습니다. Instinct GPU를 탑재한 슈퍼컴퓨터는 현재 암 치료, 지속 가능한 에너지, 기후 변화 연구 등에 활용되고 있습니다.
고성능 컴퓨팅(HPC)은 과학 연구, 엔지니어링, 보안 및 기타 분야에 필수적인 복잡한 시뮬레이션과 계산을 수행하며 현대 사회의 필수적인 부분이 되었습니다. 그러나 슈퍼컴퓨터와 대규모 데이터센터를 중심으로 HPC 수요가 증가함에 따라 환경 영향에 대한 우려가 커졌습니다. 최근 몇 년 동안 총소유비용(TCO)과 기후 문제에 대한 우려로 인해 데이터센터의 지속가능성에 대한 관심이 더욱 높아졌습니다.
Instinct GPU가 인텔리전스와 고성능 컴퓨팅을 가속화하는 방식
세계에서 가장 강력한 메인프레임과 슈퍼컴퓨터가 엑사스케일 처리를 달성할 수 있도록 하기 위해 AMD Instinct 가속기는 수많은 기술적 개선과 혁신을 갖춰야 했습니다.
AMD Instinct GPU에 사용된 몇 가지 새롭고 업데이트된 기술에 대해 살펴보겠습니다.
1. CDNA 아키텍처 기술
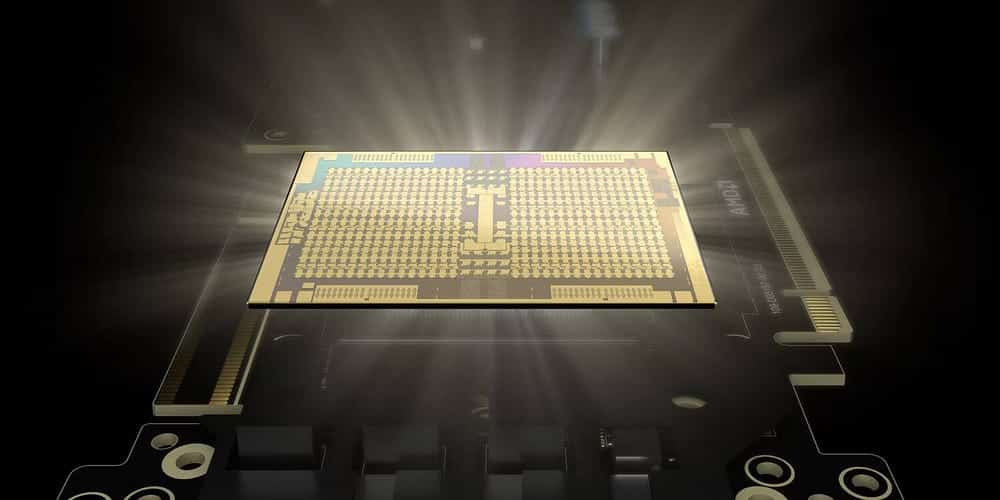
최근 AMD Instinct 가속기(MI100부터 시작)는 해당 회사의 CDNA 아키텍처를 사용했습니다.
CDNA는 자체 Matrix Core 기술을 통해 병렬 처리, 메모리 계층 구조, 그리고 향상된 컴퓨팅 성능과 같은 기능에 주로 중점을 둡니다. 단일 서버에서 실행되는 HPC, AI, 머신러닝은 물론, 대규모 엑사스케일 컴퓨터까지도 CDNA를 통해 지원할 수 있습니다.
AMD 매트릭스 코어 기술은 혼합 정밀도 연산을 지원하여 AI 학습을 가속화합니다. 다양한 정밀도로 연산할 수 있는 기능을 통해 Instinct GPU는 원하는 정밀도 수준에 따라 행렬 연산을 효율적으로 계산할 수 있습니다.
가장 일반적인 산술 정밀도 형식에는 FP64, FP32, FP16, BF16, INT8이 있습니다. FP는 부동 소수점(Floating Point), BF는 브레인 부동 소수점(Brain Floating Point), INT는 정수(Integer)를 의미합니다. 형식에 해당하는 숫자가 클수록 정밀도가 높아집니다. 64비트에서 동작하는 것을 배정밀도(Double Precision), 32비트에서 동작하는 것을 단정밀도(Single Precision), 16비트에서 동작하는 것을 반정밀도(Half Precision)라고 합니다.
딥 러닝 모델 학습의 대부분은 높은 정밀도를 요구하지 않기 때문에, 추론을 위해 절반 또는 1/4 정밀도로 행렬 연산을 계산할 수 있으면 작업 부하가 크게 줄어들어 AI 학습이 가속화됩니다. 확인해 보세요. Snapchat과 ChatGPT의 AI: 어떤 것을 사용해야 할까요?
2. 고대역폭 메모리(HBM)
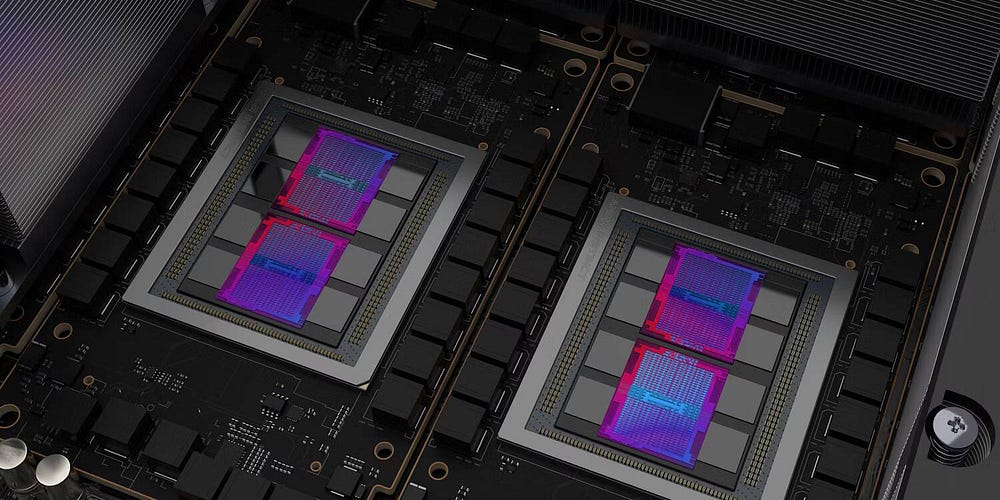
모든 AMD Instinct 가속기에는 최대 880개의 매트릭스 코어가 탑재되어 있습니다. AMD의 매트릭스 코어 프로세서는 383 TFLOP의 반정밀도 연산을 수행할 수 있으므로 고속 메모리가 필수적입니다. AMD의 최신 Instinct 제품에는 일반적인 DDR4 또는 DDR5 RAM 대신 고대역폭 메모리(HBM)가 탑재되어 있습니다.
기존 메모리와 달리 HBM은 3차원 적층 구조라고 알려진 방식을 사용합니다. 이 구조는 DRAM 모듈을 수직으로 쌓아 올리는 설계 방식을 의미합니다. 이를 통해 수직 및 수평 방향 모두로 모듈을 쌓을 수 있으므로 3차원 적층이라고 합니다.
이 3D 스태킹 기술을 사용하여 HBM은 모듈당 최대 수백 기가바이트의 물리적 메모리 용량을 구현할 수 있는 반면, DRR5는 모듈당 수십 기가바이트만 처리할 수 있습니다. 용량 외에도 HBM은 일반 DDR 메모리보다 더 높은 처리량과 더 나은 전력 효율을 제공하는 것으로 알려져 있습니다.
3. 인피니티 패브릭
Instinct GPU에 포함된 또 다른 혁신 기술은 AMD의 Infinity Fabric 기술입니다. Infinity Fabric은 CPU와 GPU를 동적이고 지능적인 방식으로 연결하는 일종의 상호 연결 시스템입니다. 이를 통해 구성 요소 간 효율적인 통신이 가능합니다.
Infinity Fabric을 사용하면 구성 요소를 일반 버스로 연결하는 대신 구성 요소를 메시와 같은 구성으로 연결하여 대역폭을 초당 수백 기가비트까지 늘릴 수 있습니다.
Infinity Fabric은 메시형 상호 연결 외에도 각 모듈에 내장된 센서를 사용하여 주파수, 데이터 전송 속도 및 기타 적응형 동작을 동적으로 제어하여 성능을 향상시키고 지연 시간을 줄입니다.
4. ROCm 개발 플랫폼
NVIDIA의 CUDA(Compute Unified Device Architecture)는 AI 모델 학습에 가장 널리 사용되는 개발 플랫폼입니다. CUDA의 문제점은 NVIDIA GPU에서만 작동한다는 것입니다. 이것이 NVIDIA가 HPC 및 AI 가속기 시장에서 압도적인 점유율을 차지하는 주요 이유 중 하나입니다.
AMD는 HPC 및 AI 시장에서 더 큰 점유율을 확보하고자 자체 플랫폼인 ROCm(Radeon Open Compute)을 개발해야 했습니다. ROCm은 Instinct GPU를 AI 가속기로 사용할 수 있도록 지원하는 오픈소스 소프트웨어 플랫폼입니다.
ROCm은 Instinct 하드웨어의 필수 구성 요소는 아니지만, Instinct GPU 제품군의 생존에 필수적입니다. ROCm을 통해 개발자와 연구자는 ROCm 도구, 컴파일러, 커널 드라이버, 전체 라이브러리, 그리고 TensorFlow 및 PyTorch와 같은 프레임워크를 활용하여 자신이 선호하는 AI 프로그래밍 언어로 개발할 수 있습니다.
AMD Instinct AI 가속기는 Radeon 동급 제품과 어떻게 비교됩니까?
AMD는 일반 소비자를 대상으로 Instinct 엔터프라이즈 GPU와 Radeon GPU 제품군을 제공합니다. 앞서 언급했듯이 Instinct 프로세서는 AMD의 CDNA 아키텍처, HBM, 그리고 Infinity Fabric 인터커넥트를 사용합니다. 반대로 Radeon 프로세서는 AMD의 RDNA 아키텍처, DDR6 메모리, 그리고 Infinity Cache를 사용합니다.
Radeon 시리즈 AI 가속기는 성능이 다소 떨어지지만, 여전히 컴퓨팅 유닛당 AI 가속 코어를 하나 또는 두 개 탑재하고 있습니다. 최신 Radeon RX7900 XT GPU는 컴퓨팅 유닛당 AI 가속 코어를 두 개 탑재하여 최대 반정밀도 103 TFLOP, 최대 단정밀도 52 TFLOP의 성능을 제공합니다.
Instinct 시리즈 GPU는 LLM과 HPC에 더 적합하지만, Radeon AI 가속기는 사전 학습된 모델의 미세 조정, 추론 및 그래픽을 많이 사용하는 작업에 사용할 수 있습니다.
AMD Instinct와 NVIDIA Tensor 비교
한 조사에 따르면 트렌드 포스 엔비디아는 서버 GPU 시장 점유율 약 80%를 차지하고 있으며, AMD는 나머지 20%만을 점유하고 있습니다. 엔비디아의 압도적인 성공은 GPU 설계 및 조립 전문성에서 비롯됩니다. 이를 통해 엔비디아는 다른 제품과는 비교할 수 없는 탁월한 성능의 GPU를 설계할 수 있습니다.
AMD의 Instinct MI205X와 NVIDIA의 H100SXM5를 사양을 사용하여 비교해 보겠습니다. AMD 공식 홈페이지NVIDIA 데이터시트 그녀 자신의:
| GPU 유형 | FP64(TFLOP) | FP32(TFLOP) | FP16(TFLOP) | INT8(TFLOP) |
|---|---|---|---|---|
| AMD 인스팅트 MI250X | 30.0 | 60.0 | 1000 | 2000 |
| 엔비디아 H100SXMS | 47.9 | 95.7 | 383.2 | 383 |
표에서 볼 수 있듯이 AMD MI250X는 배정밀도 및 반정밀도 계산에서 더 나은 성능을 보이는 반면, NVIDIA H100SXMS는 반정밀도 및 1/4정밀도 행렬 계산에서 훨씬 더 나은 성능을 보입니다. 따라서 AMD MI250X는 HPC에 더 적합하고, NVIDIA H100SXMS는 AI 학습 및 추론에 더 적합합니다. 확인해 보세요. Linux에서 AMD 대 NVIDIA 그래픽 카드: 어떤 것을 사용해야 할까?
AMD Instinct 프로세서의 미래
AMD의 최신 제품인 MI250X는 HPC용으로 설계되었지만, 곧 출시될 MI300은 AI 학습에 더욱 중점을 두고 있습니다. 이 AI 가속기는 GPU와 CPU를 단일 패키지로 결합한 APU로 발표되었습니다. 이를 통해 MI300 GPU는 GPU와 CPU가 하나의 메모리만 사용하는 CNDA3 통합 메모리 APU 아키텍처를 활용하여 효율성을 높이고 가격을 낮출 수 있습니다.
현재 AMD가 AI 가속기 시장에서 NVIDIA와 경쟁할 가능성은 낮지만, MI300이 출시되고 ROCm이 개선되면 AMD의 Instinct 시리즈가 NVIDIA로부터 AI 가속기 시장의 상당 부분을 빼앗아갈 수 있을 것으로 예상됩니다. 지금 바로 확인해 보세요. Nvidia GTX와 Nvidia RTX의 차이점은 무엇인가요?