기본 Excel 함수는 간단한 계산에는 적합하지만, 복잡한 데이터 분석을 처리하면 금방 복잡해집니다. 읽기 어려운 중첩된 수식, 스프레드시트를 복잡하게 만드는 여러 개의 보조 열, 데이터 변경 시 깨질 수 있는 수식 등이 발생합니다. 바로 이럴 때 Excel의 배열 수식이 도움이 됩니다.

배열 수식을 사용하면 단일 수식으로 전체 데이터 범위에 대한 계산을 수행할 수 있습니다. 따라서 당신은 할 수 있습니다 번개처럼 빠른 검색을 수행하세요각 행이나 열에 대해 별도의 수식을 작성하는 대신, 하나의 강력한 표현식으로 필터링하고 정렬할 수 있습니다. Excel은 새로운 기능은 아니지만, 일부 사람들은 이러한 기능을 사용하면 작업을 더 간단하고 효율적으로 수행할 수 있음에도 불구하고 기존 방식을 고수합니다.
로압 스리유에스
5. 검색
VLOOKUP보다 항상 더 나은 성능을 보입니다.
XLOOKUP은 처음부터 존재했어야 할 조회 함수입니다. 열 개수를 세고 오른쪽으로만 검색하는 VLOOKUP과 달리, XLOOKUP은 어느 방향으로든 작동하며 실제 열 참조를 사용합니다. 구문은 다음과 같습니다.
=XLOOKUP(조회_값, 조회_배열, 반환_배열, [if_not_found], [일치_모드], [검색_모드])
각 매개변수의 의미는 다음과 같습니다.
- 조회_값: 찾으려는 구체적인 값입니다. 이는 부품 번호, 제품 코드 또는 데이터 세트의 식별자일 수 있습니다.
- 조회_배열: Excel에서 검색하는 범위 lookup_value 귀하의. 이는 일반적으로 검색 기준이 포함된 단일 열 또는 행입니다.
- 반환 배열: 검색하려는 값이 포함된 범위입니다. 이는 단일 열, 여러 열 또는 전체 표 섹션일 수 있습니다.
- if_not_found(선택 사항): 일치하는 항목이 없을 때 표시할 사용자 지정 텍스트 또는 값입니다. 이 기능을 사용하면 귀찮은 #N/A 오류를 제거하고 대신 "찾을 수 없음" 또는 "부품 번호 확인"을 표시할 수 있습니다.
- match_mode(선택 사항): 일치 유형을 제어합니다. 정확한 일치(기본값)에는 0을 사용하고, 다음 정확한 일치 또는 더 짧은 일치에는 -1을 사용하고, 다음 정확한 일치 또는 더 긴 일치에는 1을 사용하고, 와일드카드 일치에는 2를 사용합니다.
- 검색 모드(선택 사항): 검색 방향을 지정합니다. 처음부터 끝까지 검색(기본값)하려면 1을, 마지막부터 처음으로 검색하려면 -1을, 정렬된 데이터에 대한 이진 검색을 하려면 2를 사용합니다.
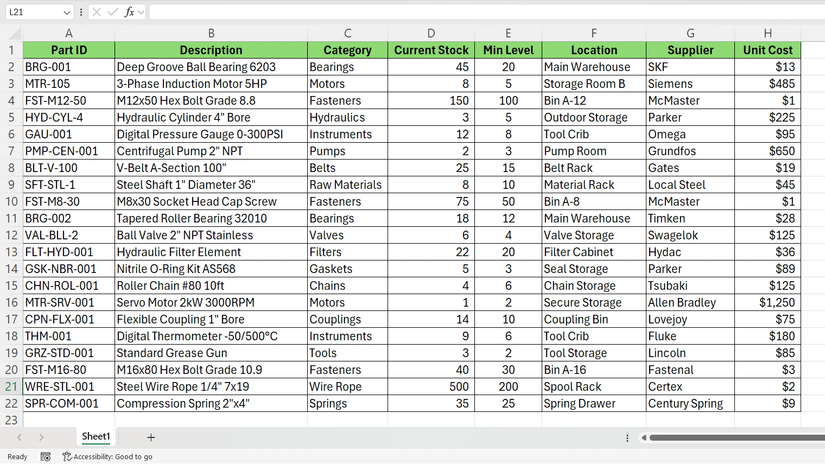
기계 재고 스프레드시트를 예로 들어 보겠습니다. 다음 수식은 부품 ID 범위 내에서 부품 번호 "BRG-002"를 검색하여 해당 데이터를 반환합니다. 해당 부품이 없으면 오류 대신 "부품을 찾을 수 없음"이 표시됩니다.
=XLOOKUP("BRG-002", A:A, A:H, "부품을 찾을 수 없습니다")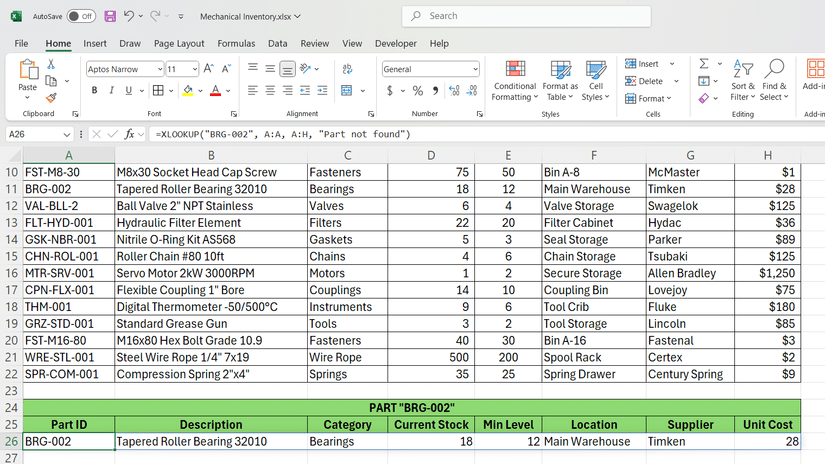
XLOOKUP을 사용하면 VLOOKUP에서 발견되는 번거로운 열 계산 없이 다른 열에서 데이터를 추출할 수 있으므로 가장 중요한 기능 중 하나입니다. 데이터를 빠르게 찾는 Excel 함수.
4. SUMPRODUCT
조건부 계산을 위한 발전소
SUMPRODUCT는 숫자를 더할 뿐만 아니라 행렬을 곱하고 그 결과를 더합니다. 따라서 여러 개의 보조 열이 필요한 복잡한 조건식 계산에 유용합니다.



그 공식은 다음과 같습니다.
=SUMPRODUCT(array1, [array2], [array3], ...)
여기, array1 이는 곱해질 값의 첫 번째 범위입니다. 일반적으로 수량이나 비용과 같은 기본 데이터 열입니다. array2 이는 곱셈을 위한 선택적인 두 번째 범위로, 종종 비교 연산자를 사용한 기준이나 조건 논리를 포함합니다.
배열 내에서 논리 연산자를 사용하면 더욱 유용합니다. 예를 들어, (supplier="Siemens")와 같은 조건을 입력하면 Excel에서 TRUE/FALSE 결과를 1/0으로 변환하여 계산을 수행할 수 있습니다.
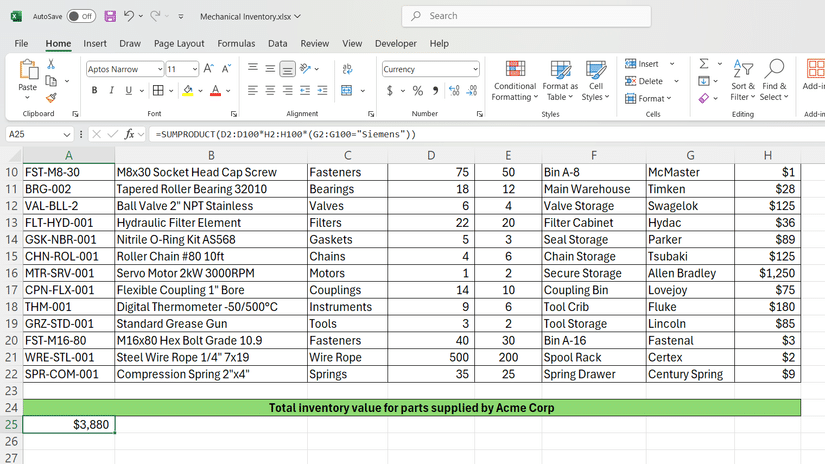
예를 들어, 다음 수식은 Siemens에서만 공급하는 부품의 총 재고 가치를 계산합니다. 이 수식은 수량을 단위 원가에 곱하지만, 공급업체가 기준을 충족하는 행에 대해서만 곱합니다.
=SUMPRODUCT(D2:D100*H2:H100*(G2:G100="Siemens"))
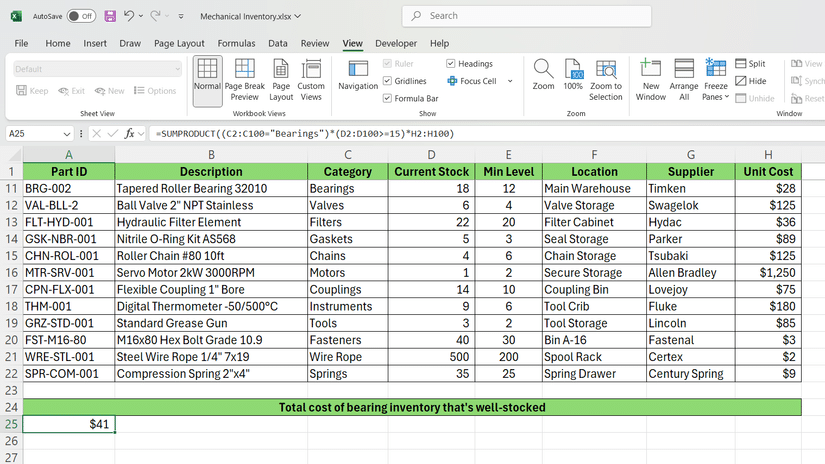
마찬가지로, 다음 공식은 양호한 공급량의 베어링 재고의 총 비용을 구합니다.
=SUMPRODUCT((C2:C100="Bearings")*(D2:D100>=15)*H2:H100)
두 가지 조건이 동시에 적용됩니다. 카테고리는 "베어링"이어야 하고 재고 수준은 15개 이상이어야 합니다. 이를 통해 충분한 재고 범위를 갖춘 베어링 카테고리를 식별하는 데 도움이 됩니다.
여러 조건을 사용하는 기존 SUM 함수와 달리 SUMPRODUCT는 하나의 읽기 쉬운 수식에서 여러 조건을 처리하므로 복잡한 중첩 구조가 필요하지 않습니다. Excel의 SUM 함수 SUMIF 및 SUMIFS와 마찬가지로 이 함수들은 간단한 조건부 합계에 적합하지만, SUMPRODUCT 함수는 합계를 계산하기 전에 값을 곱해야 하거나 보다 복잡한 논리 연산을 처리할 때 더욱 효과적입니다.
3. 필터
동적 데이터 추출을 간편하게 만듭니다.
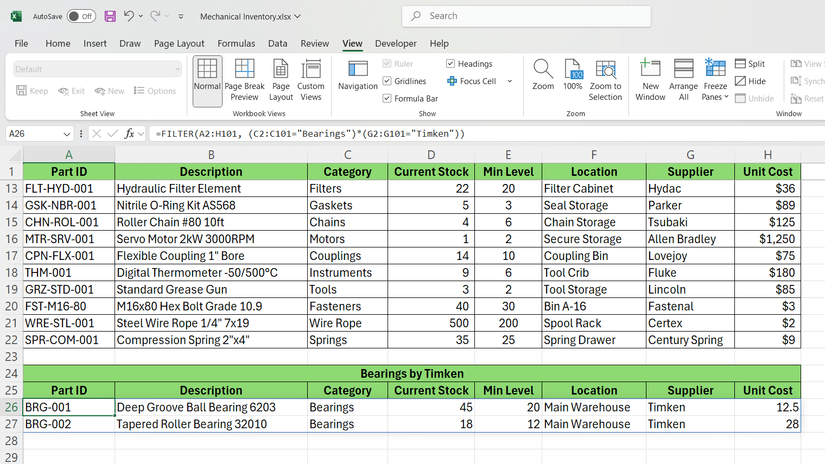
FILTER는 사용자가 지정한 조건에 따라 데이터세트에서 행을 추출합니다. 수동 필터링과 달리, 이 함수는 원본 데이터가 변경될 때 자동으로 업데이트되는 동적 결과를 생성합니다. FILTER 구문은 다음과 같습니다.
=FILTER(배열, 포함, [if_empty])
각 입력이 제어하는 내용은 다음과 같습니다.
- 배열(범위): 필터링할 전체 데이터 범위입니다. 여기에는 기준 열뿐만 아니라 결과에 포함할 모든 열이 포함됩니다.
- 포함하다(include): 어떤 행을 반환할지 지정하는 논리적 조건 - 비교 연산자를 사용하여 각 행에 대한 TRUE/FALSE 배열을 만듭니다.
- if_empty(선택 사항): 조건에 맞는 행이 없을 때 사용자 지정 메시지를 표시합니다. #CALC! 오류를 방지하고 "일치하는 결과가 없습니다."와 같은 의미 있는 텍스트를 표시합니다.
이 함수는 범위의 각 행에 대해 조건을 평가하여 작동합니다. 조건이 TRUE를 반환하면 해당 행 전체가 필터링된 결과에 나타납니다. 다음은 기계 재고 스프레드시트의 예입니다.
=FILTER(A2:H101, (C2:C101="Bearings")*(G2:G101="Timken"))
이 수식은 리소스가 "Timken"이고 카테고리가 "Bearings"인 모든 행을 추출합니다. 별표(*)는 논리 배열을 서로 곱하여 AND 조건을 생성합니다.
소스 범위에 새 데이터를 추가하는 경우 Excel에서 FILTER 함수 사용하기 필터링된 결과는 자동으로 업데이트되므로 수동 정렬이나 임시 테이블보다 효율적입니다. 따라서 실시간 대시보드와 보고서를 만드는 데 유용합니다.
2. UNIQUE
중복 없이 고유한 값 추출
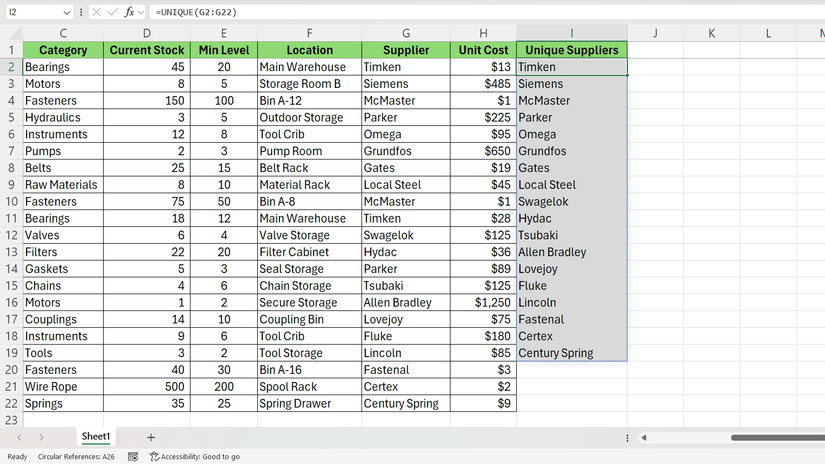
UNIQUE 함수는 데이터 범위에서 고유한 값을 추출하여 중복을 자동으로 제거합니다. 이 함수는 드롭다운 목록을 만들고, 데이터 범주를 분석하고, 요약 보고서를 작성할 때 유용합니다. 수식은 다음과 같습니다.
=UNIQUE(array, [by_col], [exactly_once])
각 입력의 작동 방식은 다음과 같습니다.
- 배열(범위): 중복을 제거하려는 데이터가 포함된 범위입니다. 단일 열, 여러 열 또는 표의 전체 섹션일 수 있습니다.
- by_col(선택사항): FALSE는 고유성을 확인하기 위해 행을 비교하고(기본값), TRUE는 열을 비교합니다. 하지만 대부분의 경우 기본 행 비교를 사용합니다.
- exact_once (선택 사항): FALSE는 여러 번 발생하는 값(기본값)을 포함하여 모든 고유한 값을 반환하고, TRUE는 데이터 집합에서 정확히 한 번 발생하는 값만 반환합니다.
UNIQUE 함수는 배열의 각 행 또는 값을 평가하여 각 고유 요소의 첫 번째 항목만 반환합니다. 순서는 원래 데이터 시퀀스와 일치합니다. 예를 들어 다음과 같습니다.
=UNIQUE(G2:G22)
이 수식은 공급업체 열 G에서 모든 고유 공급업체 이름을 추출하여 깔끔한 중복 목록을 생성합니다. 저는 이 수식을 공급업체 드롭다운 목록이나 요약 보고서를 만드는 데 사용합니다.
아래와 같이 전체 표에 사용할 수도 있습니다.
=UNIQUE(A2:F100)
모든 열(A~F)에 걸쳐 고유한 조합을 반환하여 서로 다른 재고 레코드를 표시합니다. 각 열에서 두 부품의 값이 동일한 경우, 결과에는 하나만 표시됩니다.
대용량 데이터세트를 다룰 때 UNIQUE는 중복된 데이터를 수동으로 제거하는 번거로운 과정을 없애줍니다. 새로운 데이터가 도착하면 동적 결과가 업데이트되고, UNIQUE는 스필오버 행렬을 생성하기 때문에 모든 고유 값을 수용하도록 자동으로 크기가 조정되어 테이블 크기를 조정하는 번거로움을 없앨 수 있습니다. 저는 이 기능을 사용하여 깔끔한 참조 목록을 유지하고 신뢰할 수 있는 데이터 검증 범위를 구축합니다.
1. SORT 및 SORTBY
원본을 손상시키지 않고 데이터를 구성하세요
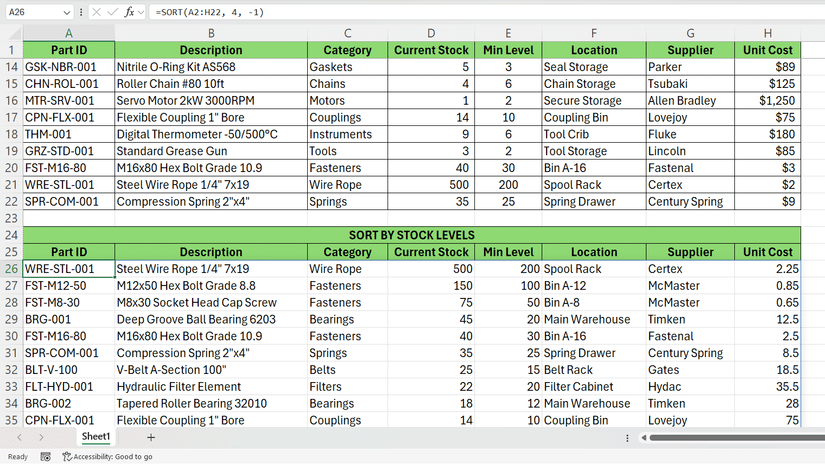
SORT 및 SORTBY 함수는 소스 데이터를 그대로 유지하면서 데이터를 동적으로 구성합니다. SORT는 열 위치를 기준으로 기본적인 정렬을 처리하는 반면, SORTBY는 여러 열의 값을 기준으로 정렬하므로 복잡한 정렬 작업도 더욱 유연하게 수행할 수 있습니다.
SORT는 다음 구조를 사용합니다.
=SORT(배열, [sort_index], [sort_order], [by_col])
각 매개변수가 제어하는 내용은 다음과 같습니다.
- 정렬: 정렬하려는 데이터 범위에는 정렬된 결과에 나타나야 하는 모든 열이 포함됩니다.
- sort_index (선택사항): 정렬 기준으로 사용할 배열 내 열 번호입니다. 첫 번째 열은 1, 두 번째 열은 2 등으로 지정합니다(기본값은 1).
- sort_order(선택사항): 오름차순(기본값)의 경우 1을 사용하고, 내림차순의 경우 -1을 사용합니다.
- by_col(선택사항): 행을 기준으로 정렬하려면 FALSE(기본값), 열을 기준으로 정렬하려면 TRUE를 지정합니다. 대부분의 시나리오에서는 행 정렬을 사용합니다.
SORTBY 함수의 형식은 다음과 같습니다.
=SORTBY(배열, by_array1, [정렬_순1], [by_array2], [정렬_순2], ...)
거래 내역은 다음과 같습니다.
- 정렬: 정렬할 데이터 범위 - SORT 함수와 비슷하게 결과에 포함할 모든 열을 포함합니다.
- by_array1: 정렬 순서를 결정하는 값이 포함된 범위는 기본 배열의 범위를 벗어나는 모든 열일 수 있습니다.
- sort_order1(선택 사항): 1은 오름차순(기본값), -1은 내림차순입니다.
- by_array2, sort_order2(선택 사항): 다중 레벨 정렬을 위한 추가 정렬 기준.
기계식 재고 스프레드시트의 예를 살펴보면, 이러한 기능은 실제 정렬 시나리오를 처리합니다.
=SORT(A2:H22, 4, -1)
이 수식은 전체 재고를 재고 수준을 기준으로 내림차순으로 정렬하며, 재고 수준이 가장 높은 품목이 먼저 표시됩니다. 이 수식은 행 간의 모든 관계를 유지하면서 4열(재고 수준)을 기준으로 정렬합니다.
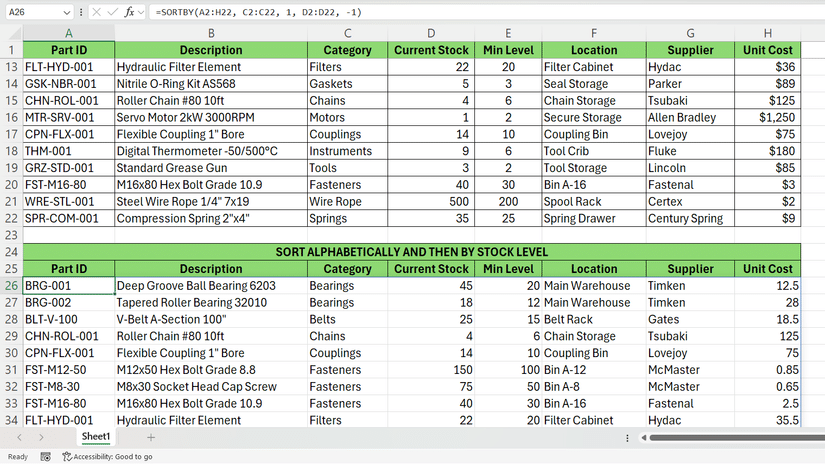
저는 SORTBY 함수를 사용하고 있습니다. SORT 대신 SORT를 사용하면 정렬 기준과 여러 정렬 수준을 더욱 효과적으로 제어할 수 있습니다. 예를 들어, 다음 수식은 먼저 범주별로 알파벳순으로 정렬한 다음, 각 범주 내에서 재고 수준을 기준으로 가장 높은 것부터 가장 낮은 것 순으로 정렬합니다.
=SORTBY(A2:H22, C2:C22, 1, D2:D22, -1)
체계적인 스프레드시트, 더욱 스마트한 결과
배열 수식은 스프레드시트 유지 관리를 어렵게 만드는 복잡한 도우미 열과 중첩 함수를 제거합니다. 여러 작업을 처리하는 단일 수식을 사용하면 통합 문서를 더욱 깔끔하고 전문적으로 만들 수 있습니다.
주목할 만한 장점 중 하나는 동적 함수입니다. 원본 데이터가 변경되면 결과가 자동으로 업데이트됩니다. 이를 통해 수동 업데이트나 잘못된 수식 문자열을 방지하고 지속적인 분석을 위해 스프레드시트의 안정성을 높일 수 있습니다.
Excel의 배열 함수 라이브러리는 이러한 기본 도구를 넘어 계속해서 확장되고 있습니다. 여러 소스의 데이터를 결합해야 할 때는 VSTACK 및 HSTACK 함수를 사용하여 범위를 결합합니다. 이러한 함수를 함께 사용하면 기존 수식으로는 불가능했던 강력한 데이터 처리 워크플로를 만들 수 있습니다.