수년간 복잡하고 지저분한 스프레드시트를 다루던 저는 대부분의 사람들이 수동으로 수행하는 일상적인 작업을 자동화하여 매주 몇 시간씩 작업 시간을 절약해 주는 네 가지 Excel 함수를 발견했습니다. 이 함수들은 전문 데이터 분석가든, 업무를 간소화하려는 일반 사용자든 정기적으로 데이터를 다루는 모든 사람에게 필수적입니다.

로압 스리유에스
4. XLOOKUP: 스프레드시트의 고급 조회
검색 Microsoft Excel 및 Google Sheets와 같은 스프레드시트 프로그램에서 기존 검색 기능의 기능을 뛰어넘는 고급 검색 기능입니다. VLOOKUP و 조회. 가용성 검색 더 큰 유연성, 더 효율적인 데이터 처리, 기존 기능과 관련된 일반적인 오류 감소. 검색 재무 분석가, 데이터 과학자, 그리고 방대한 데이터를 다루며 특정 정보를 빠르고 정확하게 추출해야 하는 모든 사람에게 필수적인 도구입니다. 검색열이나 행의 위치에 관계없이 특정 범위에서 값을 검색하여 다른 범위에서 해당 값을 반환할 수 있습니다. 또한 다음을 지원합니다. 검색 오른쪽에서 왼쪽으로, 아래에서 위로 검색하기 때문에 다른 기능보다 다재다능합니다.
VLOOKUP은 이제 안녕입니다. XLOOKUP이 완벽한 솔루션입니다.
몇 년 전 XLOOKUP을 알게 된 후 VLOOKUP 사용을 중단했습니다. VLOOKUP은 오른쪽으로만 검색하고 열을 이동하면 충돌이 발생하는 반면, XLOOKUP은 어느 방향으로든 작동하며 유연성을 유지합니다. XLOOKUP은 시간을 절약할 수 있는 Excel 함수 스프레드시트에서 특정 데이터를 찾으세요.
컴퓨터 부품 가격 데이터에서 제품 모델별 특정 GPU 가격을 찾아야 합니다. VLOOKUP을 사용하면 전체 표를 재구성해야 합니다. 하지만 XLOOKUP을 사용하면 다음과 같이 입력하기만 하면 됩니다.
=XLOOKUP("GIGABYTE GeForce RTX 3060 12GB Gaming OC", C:C, D:D)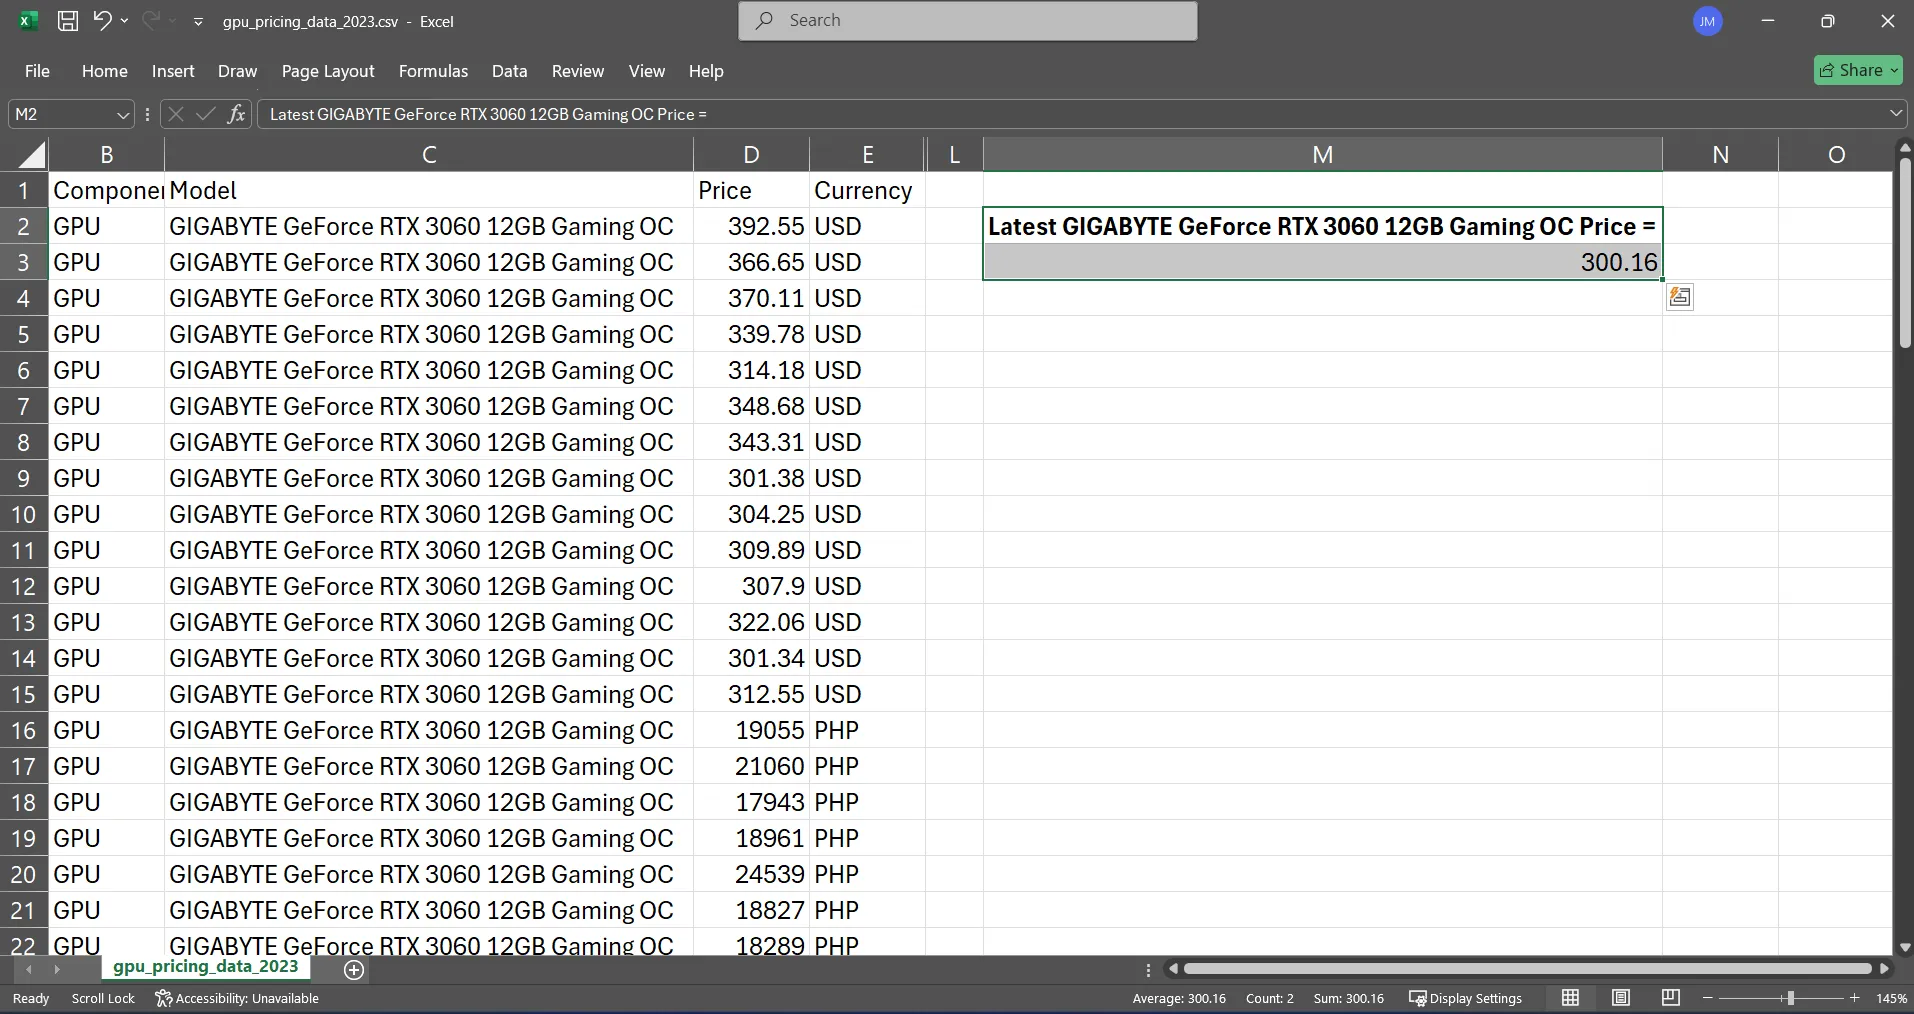
XLOOKUP은 전체 제품 열을 검색하여 제 GPU를 찾은 후 해당 가격을 반환합니다. 가격 열의 위치는 중요하지 않으며, 나중에 열을 더 추가해도 충돌이 발생하지 않습니다. 저는 여러 시트에서 제품 정보를 참조할 때 서식을 다시 지정할 필요가 없어 항상 이 기능을 사용합니다.
XLOOKUP의 기본 수식은 다음과 같습니다.
=XLOOKUP(조회_값, 조회_배열, 반환_배열)
- 조회_값: 검색하려는 값입니다.
- 조회_배열: 가치를 찾는 곳.
- 반환 배열: 반환하려는 값이 포함된 열 또는 행입니다.
제 경우, 찾고자 했던 값은 "GIGABYTE GeForce RTX 3060 12GB Gaming OC"였습니다. C:C 열에서 이 값을 찾고, 일치하는 값이 있는 행의 D:D에서 해당 값을 반환하고 싶었습니다.
XLOOKUP의 또 다른 장점은 수식 끝에 ",-1"을 추가하면 아래에서 위로 검색하여 가장 최근 가격 항목을 자동으로 찾아준다는 것입니다. 덕분에 스프레드시트를 새로 고칠 때마다 데이터를 수동으로 정렬할 필요가 없습니다.
3. 내 기능 사용 사명 و 카운티 스프레드시트에서
다양한 표준을 전문적으로 처리
기본적인 SUM과 COUNT 함수는 간단한 작업에는 충분하지만, 실제 분석에는 부족합니다. 여러 조건에서 가격 데이터를 분석해야 할 때는 일반적으로 SUMIFS와 COUNTIFS 함수를 사용합니다. 이 함수들을 사용하면 수백 개의 행을 쉽게 분할할 수 있습니다.



Amazon US에서 판매되는 AMD 프로세서의 개수를 세고 싶다고 가정해 보겠습니다. 수동으로 필터링하는 대신 다음과 같이 입력합니다.
=COUNTIFS(F:F, "Amazon US", K:K, "AMD")
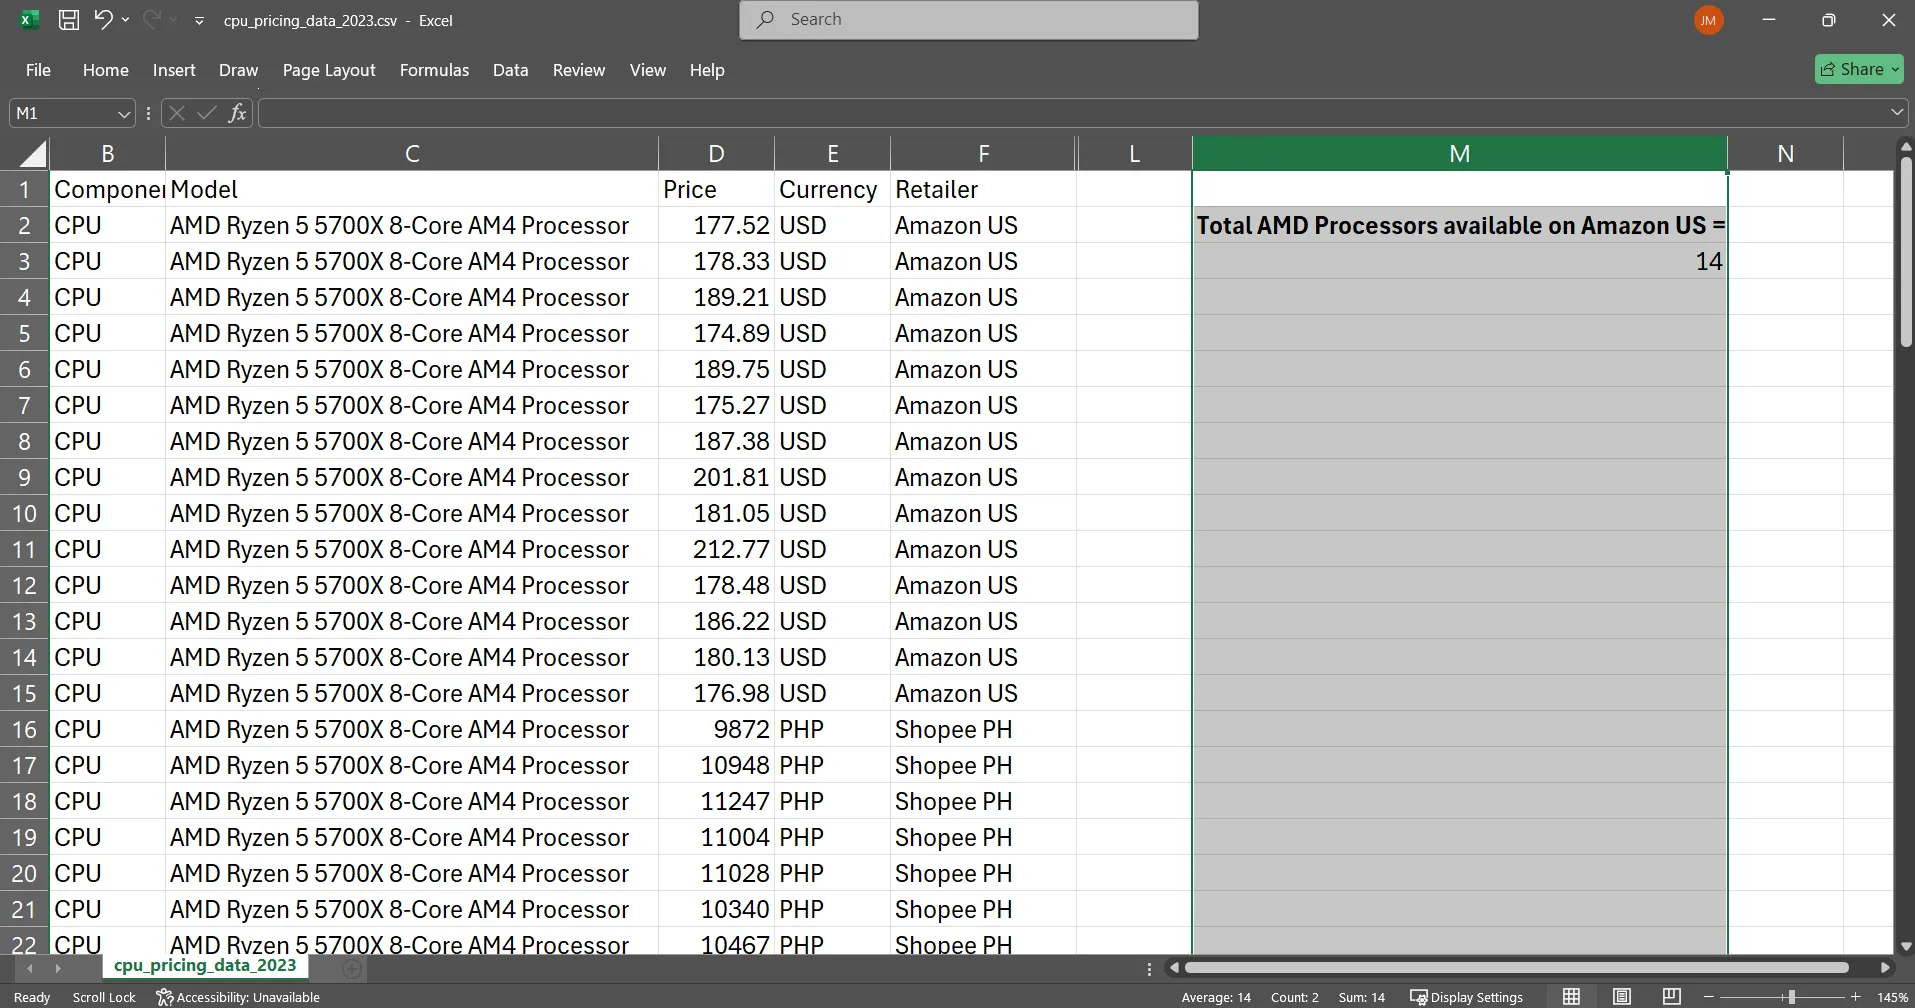
이렇게 하면 제 데이터 세트에 Amazon에 등록된 AMD 프로세서가 14개 있다는 것을 바로 알 수 있습니다. 여기서 좋은 점은 필요한 만큼 벤치마크를 수집할 수 있다는 것입니다.
가격 분석에서는 SUMIFS 함수가 같은 방식으로 작동합니다. 현재 재고가 있는 모든 인텔 프로세서의 총 가격을 계산하려면 다음을 사용합니다.
=SUMIFS(D:D, K:K, "Intel", G:G, "재고 있음")
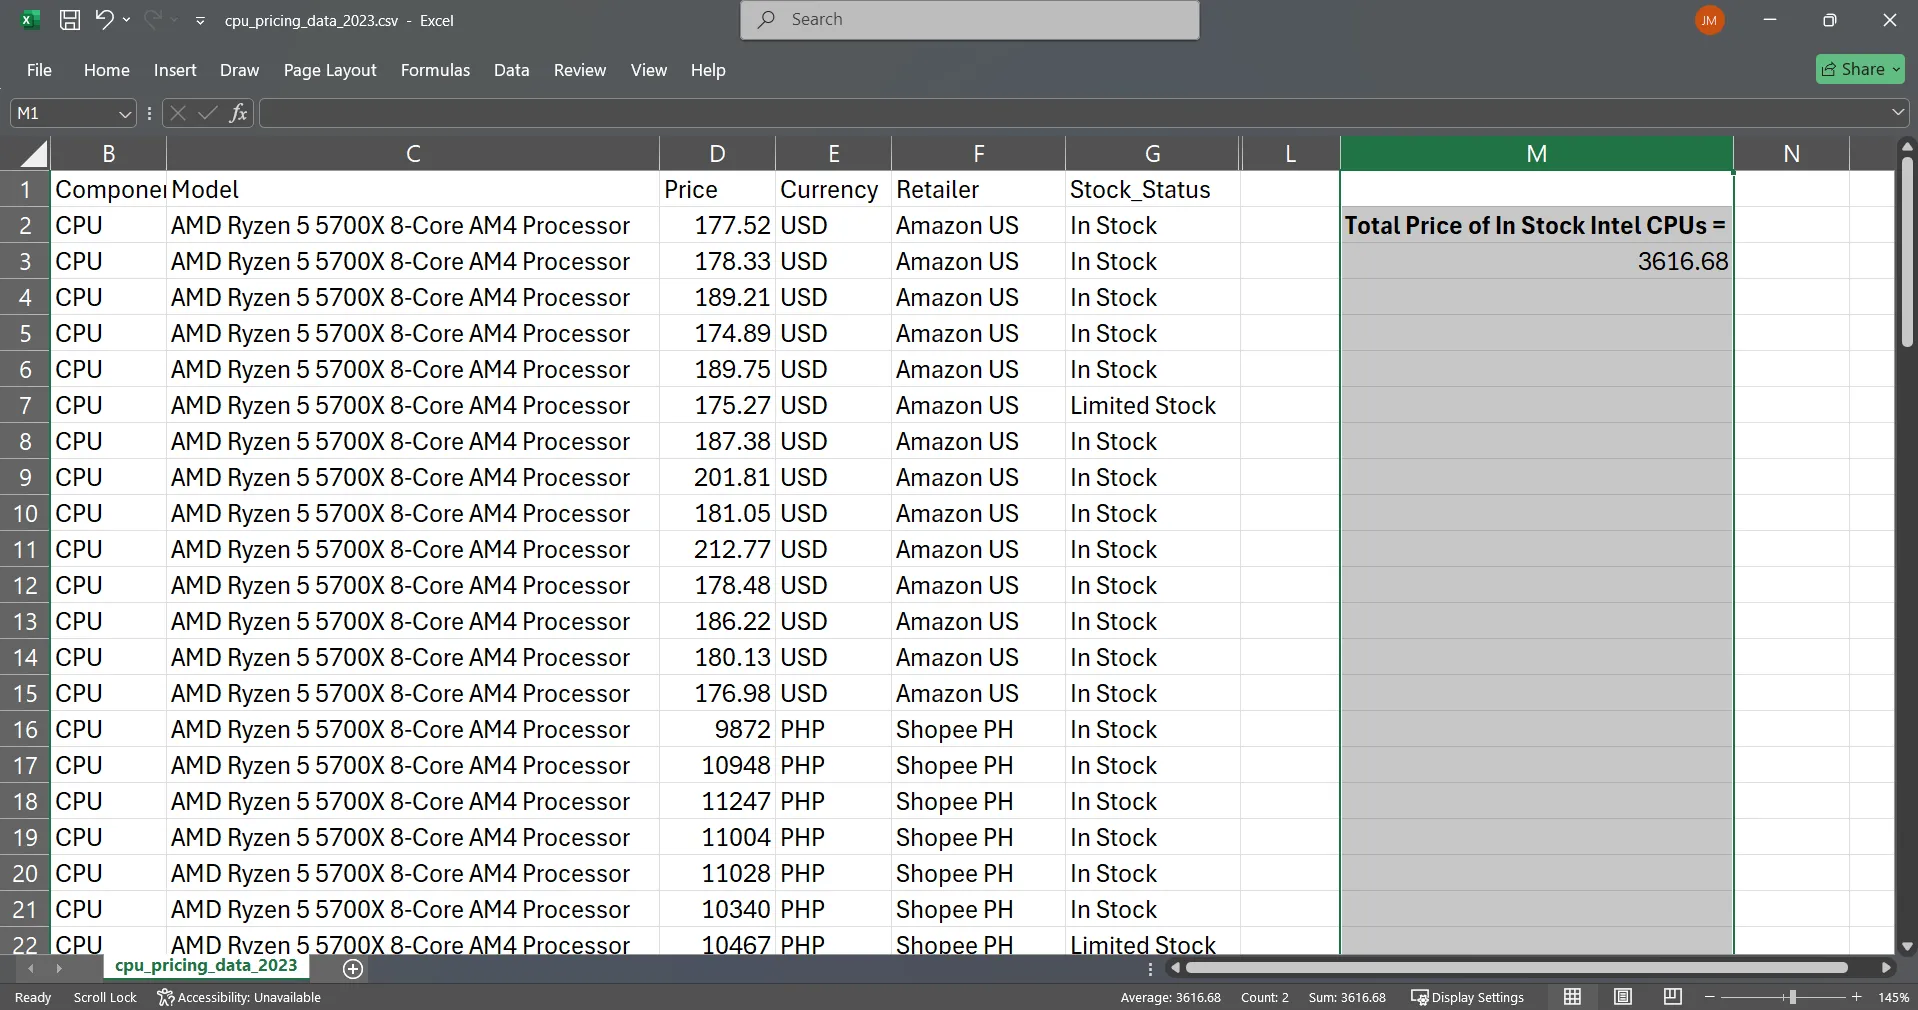
이렇게 하면 브랜드가 "인텔"이고 재고 상태가 "재고 있음"인 모든 가격이 D열에 추가됩니다.
SUMIFS 함수의 구문은 다음과 같습니다.
=SUMIFS(sum_range, criteria_range1, criteria1, criteria_range2, criteria2...)
- 합계 범위: 합계를 구하려는 열입니다.
- 기준_범위1: 조건을 확인할 첫 번째 열입니다.
- 기준1: 첫 번째 범위 조건.
- 기준_범위2, 기준2: 추가 약관(선택 사항).
COUNTIFS 함수도 비슷한 방식으로 작동하지만, 값을 합산하는 대신 일치하는 행을 계산합니다.
=COUNTIFS(criteria_range1, criteria1, criteria_range2, criteria2...)
빠른 보고서를 작성할 때는 SUMIFS와 COUNTIFS를 선호합니다. 새 데이터를 즉시 업데이트하고, 기존 수식에 깔끔하게 적용되며, 별도의 피벗 테이블을 만들지 않고도 모든 데이터를 인라인으로 관리할 수 있기 때문입니다. 이러한 도구를 사용하면 정확하고 효율적인 데이터 분석이 가능해져 복잡한 보고서 작성에 드는 시간과 노력을 절약할 수 있습니다. SUMIFS와 COUNTIFS와 같은 함수를 사용하는 것은 데이터에서 가치 있는 인사이트를 빠르고 쉽게 추출하려는 모든 데이터 분석가에게 필수적인 기술입니다.
2. 트리밍 및 청소: 외관 유지를 위한 필수 단계
데이터 혼잡에 작별 인사
불필요한 공백과 숨겨진 문자로 가득 찬 비정형 데이터만큼 스프레드시트를 빠르게 망치는 것은 없습니다. 저는 양식 이름 끝에 추가 공백이 있어서 검색이 계속 실패하면서 이 사실을 뼈저리게 깨달았습니다.
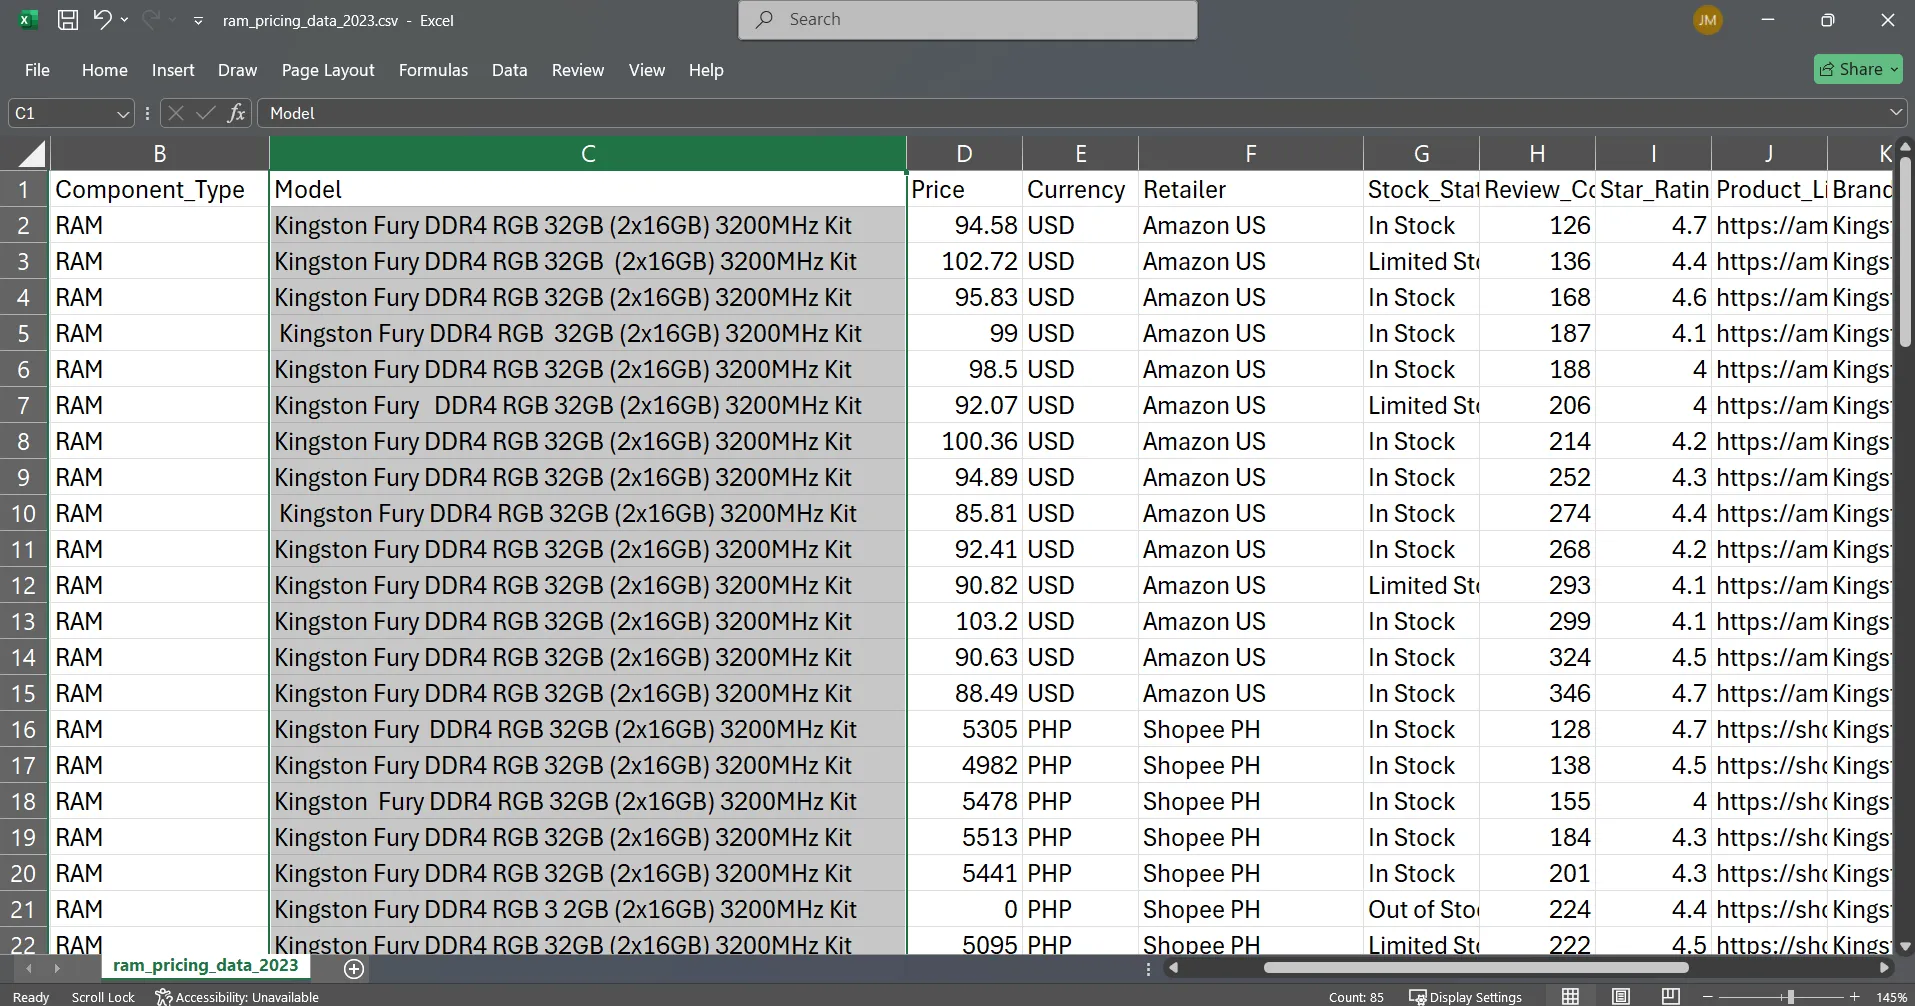
TRIM 함수는 텍스트의 시작과 끝, 그리고 단어 사이의 공백을 제거합니다. 여러 소스에서 데이터를 가져올 때 제품 이름에 일관성 없는 공백이 포함되는 경우가 많습니다. 각 셀을 직접 정리하는 대신, 보조 열을 만들고 다음을 사용합니다.
=TRIM(C2)
그런 다음 마우스 포인터를 셀 가장자리로 옮겨 더하기 기호(+)로 바꾼 다음 TRIM 함수를 적용하려는 모든 행으로 드래그합니다.
1. TEXTBEFORE와 TEXTAFTER: 자세한 설명과 그 중요성
필요한 데이터를 정확하게 추출합니다
TEXTBEFORE와 TEXTAFTER 함수는 복잡한 스프레드시트를 정리할 때 제가 가장 좋아하는 Excel 함수 중 하나입니다. Excel의 최신 텍스트 함수는 구조화되지 않은 텍스트 문자열에서 특정 정보를 추출하는 데 탁월합니다. 예를 들어, 제 가격 열에는 "$177.52", "178.33 USD", "₱9055", "9645.50 PHP"와 같은 항목이 뒤섞여 있었습니다.
TEXTBEFORE 함수는 지정된 구분 기호 앞에 있는 모든 내용을 추출합니다.
=TEXTBEFORE(D2, "USD")
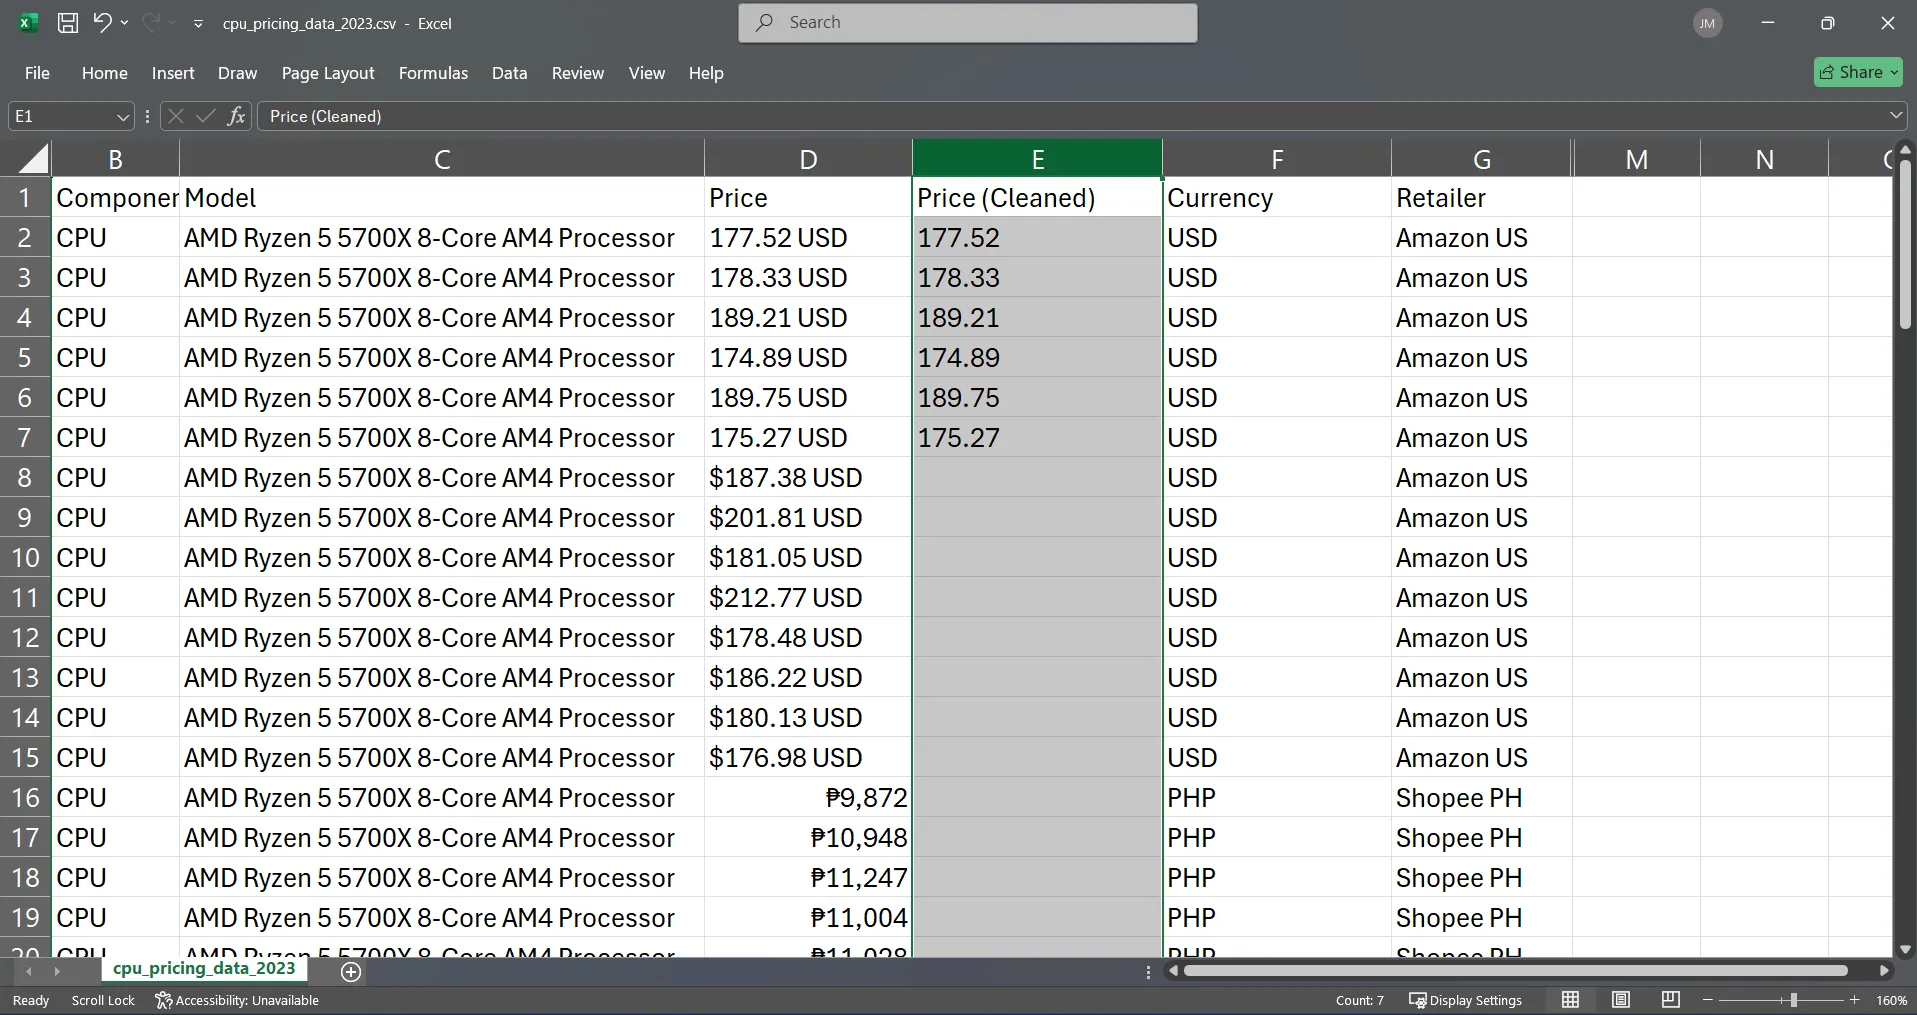
이런 방식으로 함수는 "178.33 USD"에서 "178.33"을 즉시 추출했습니다.
TEXTAFTER 함수는 반대로 동작하여 구분 기호 뒤의 모든 내용을 추출합니다.
=TEXTAFTER(C2, "AMD ")
이런 식으로 "AMD Ryzen 5 5700X 8-Core AM4 Processor"에서 "Ryzen 5 5700X 8-Core AM4 Processor" 함수를 추출했습니다.
복잡한 추출의 경우 두 함수를 결합합니다. $177.52 USD의 수치적 가격을 구하려면 다음과 같이 합니다.
=TEXTBEFORE(TEXTAFTER(D8, "$"), "USD")
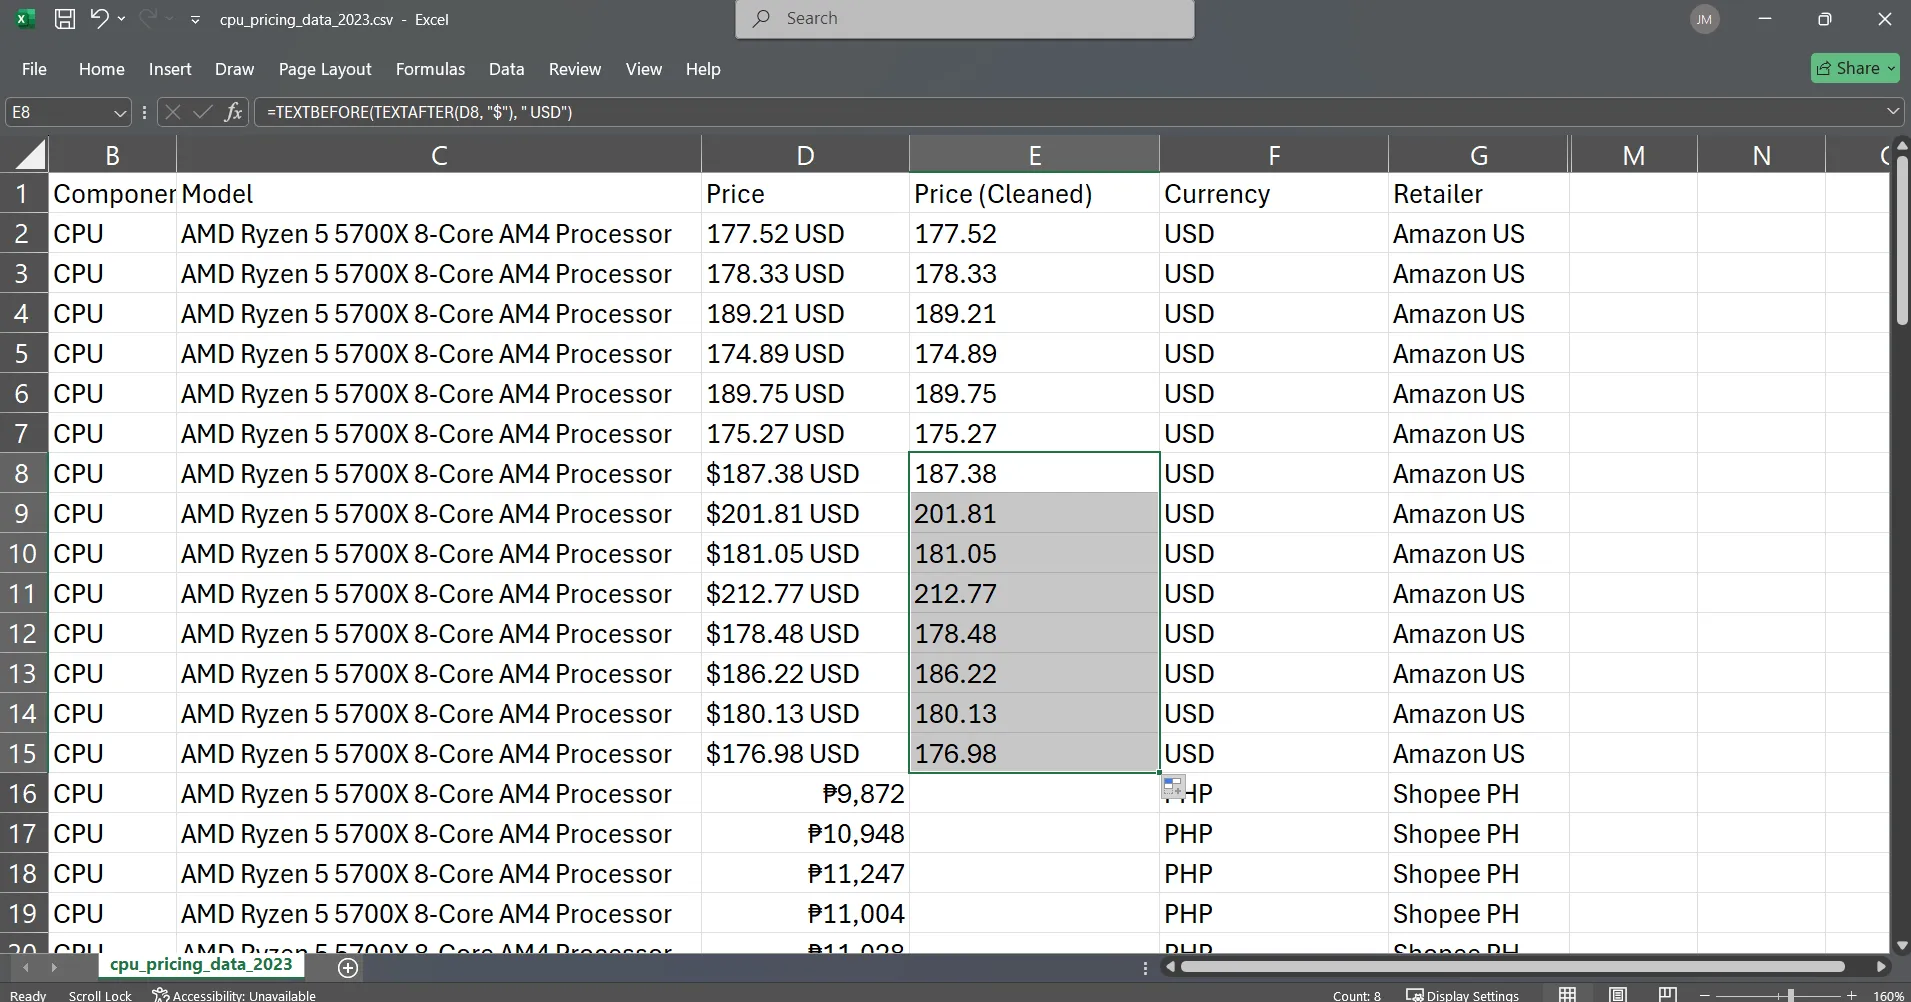
TEXTBEFORE 및 TEXTAFTER 함수의 일반 구문은 다음과 같습니다.
=TEXTBEFORE(텍스트, 구분자) 및 =TEXTAFTER(텍스트, 구분자)
이 두 함수가 가져다주는 엄청난 개선은 바로 정확도에 있습니다. MID, FIND, LEN 함수를 복잡하게 조합하는 대신, 간단하고 읽기 쉬운 수식을 사용하여 깔끔한 추출 결과를 얻을 수 있습니다. 저는 이 함수들을 자주 사용하여 모델 번호를 분리하고, 제품 사양을 추출하고, 예전에는 수작업으로 편집하는 데 많은 시간이 걸렸던 가져온 텍스트에서 깔끔한 데이터를 추출합니다.
이 네 가지 함수는 유연한 검색을 사용하여 데이터를 찾고, 여러 기준을 기반으로 분석하고, 복잡하게 가져온 텍스트를 정리하고, 복잡한 텍스트 문자열에서 특정 정보를 추출하는 등 Excel에서 가장 시간 낭비적인 작업들을 해결합니다. 대부분의 사람들은 이러한 작업을 수동으로 처리하며, 올바른 수식을 구현하는 데 보통 몇 분밖에 걸리지 않는 작업에 몇 시간을 허비합니다.
부품 가격 분석부터 재고 관리 보고서까지, 이 기능들을 사용해 보셨을 겁니다. 데이터 정리가 어렵고 검색 조건이 복잡한 것은 누구나 겪는 문제이기 때문에 업종과 관계없이 이 기능들을 활용할 수 있습니다. 이 기능들을 완전히 익히고 나면, 이 기능 없이 어떻게 스프레드시트를 관리했는지 의아해하실 겁니다.