제가 목록에 사용하는 엑셀 함수 중 상당수는 관리가 필요합니다. 새 행을 추가할 때 오류가 발생하거나 수정이 필요한 경우가 종종 있습니다. 하지만 TAKE와 DROP 함수를 사용하면 이러한 문제가 발생하지 않습니다. 이 두 함수를 사용하면... 테이블이 자동으로 확장되도록 하는 동적 매트릭스데이터 세트에서 특정 행과 열을 드래그하거나 제거하면 데이터가 변경될 때 자동으로 업데이트됩니다.

정렬(SORT) 및 필터링(FILTER)과 같은 기능을 함께 사용하면 별다른 노력 없이도 자동으로 관리되는 목록을 만들 수 있습니다. 실제로 최신 상태를 유지하는 목록을 만드는 방법을 아래에서 살펴보겠습니다.
로압 스리유에스
TAKE는 필요한 행이나 열을 정확하게 추출합니다.
데이터 경로를 지정하고 행 수를 알려주면 해당 데이터를 제공합니다.

TAKE 함수는 한 가지 일을 아주 잘 해냅니다. 사용자가 정의한 끝점에서 시작하여 지정된 개수의 행 또는 열을 범위에서 가져옵니다. 별도의 보조 열이나 데이터가 필요하지 않습니다. 인덱스 매치 간섭은 복잡합니다.데이터 경로를 지정하고 원하는 행 수를 알려주면 해당 행들을 제공해 줄 것입니다.
다음은 문장 구조입니다.
=TAKE(배열, 행, [열])
- 정렬: 추출된 소스 범위 또는 배열입니다.
- 행: 반환할 행의 개수입니다. 양수는 위쪽에서, 음수는 아래쪽에서 가져옵니다.
- 열(선택 사항): 작동 방식은 동일합니다. 왼쪽에서 양(+)의 에너지를 끌어당기고, 오른쪽에서 음(-)의 에너지를 끌어당깁니다.
예를 들어 A2:D20 셀에 매출 데이터가 있고 처음 5개 행만 추출하고 싶다면 다음 수식을 사용하면 됩니다.
=TAKE(A2:D20, 5)
마지막 세 자리 숫자가 필요하신가요? -3으로 바꾸세요. 결과는 자동으로 인접 셀로 확장되며 원본 데이터가 변경될 때마다 다시 계산됩니다.
DROP 명령은 원하지 않는 행이나 열을 제거합니다.
그녀에게 무엇을 무시해달라고 말하세요. 그러면 그녀는 나머지 모든 것을 다시 가져올 거예요.
DROP 함수는 TAKE 함수의 반대입니다. 유지할 행을 지정하는 대신, 버릴 행을 지정하면 나머지 행을 모두 반환합니다. 데이터셋의 맨 위나 맨 아래에 원치 않는 행이 몇 개 있는지 정확히 알고 있는 상황에서는 DROP 함수를 사용하는 것이 훨씬 편리합니다.
구문은 TAKE 함수를 반영합니다.
=DROP(배열, 행, [열])
- 정렬: 소스 도메인 또는 배열.
- 행: 제외할 행의 개수입니다. 양수 값은 위쪽에서 삭제되고, 음수 값은 아래쪽에서 삭제됩니다.
- 열(선택 사항): 양수 값은 왼쪽에서, 음수 값은 오른쪽에서 제거됩니다.
데이터 세트의 A2:D20 범위에 머리글처럼 보이지만 불필요한 요약 행이 두 개 있다고 가정해 보겠습니다. 다음 수식은 이 두 행을 제거하고 나머지 행을 복원합니다.
=DROP(A2:D20, 2)
다음 방법을 사용하여 열을 삭제할 수도 있습니다.
=DROP(A2:D20, 0, 1)
이 함수는 첫 번째 열을 제거하는데, ID 필드가 출력에 문제를 일으킬 때 유용합니다. TAKE 함수와 마찬가지로 결과는 데이터가 증가함에 따라 동적으로 확장되고 업데이트됩니다.
정확한 데이터 분할을 위해 TAKE 및 DROP 기능을 결합합니다.
두 조각을 서로 안에 넣어 가운데 부분을 추출하세요.
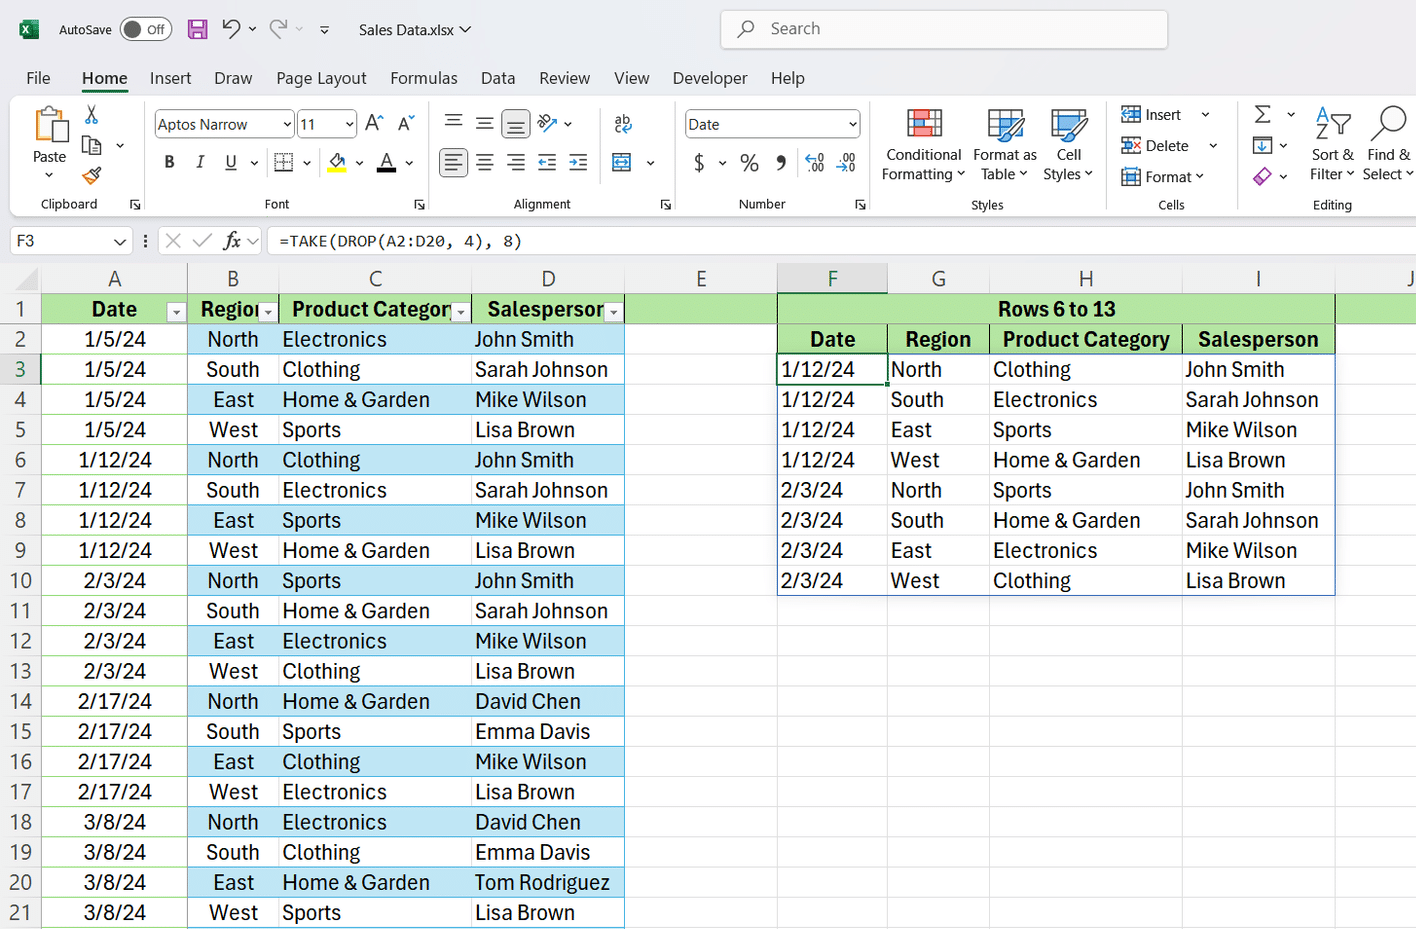
TAKE 함수와 DROP 함수는 각각 데이터셋의 가장자리 부분을 추출합니다. 하지만 이 두 함수를 함께 사용하면 데이터셋의 중간 부분을 추출할 수 있는데, 이는 어느 함수도 단독으로는 불가능한 작업입니다.
핵심은 DROP 함수를 사용하여 맨 위에서 필요 없는 행을 제거한 다음, 그 결과를 TAKE 함수로 감싸서 유지할 행 수를 줄이는 것입니다. 매출 데이터를 예로 들면, 1월 12일부터 2월 3일까지의 거래 내역 중 처음 네 개를 건너뛰고 다음 여덟 개를 가져오고 싶다고 가정해 보겠습니다. 그러면 공식은 다음과 같습니다.
=TAKE(DROP(A2:D20, 4), 8)
DROP 함수는 처음 네 행(1월 5일 항목)을 제거하고, TAKE 함수는 남은 행 중에서 다음 여덟 행을 반환합니다. 출력에는 날짜부터 영업 담당자까지 네 열이 모두 포함되므로 보조 열을 추가하거나 범위를 수동으로 정의할 필요 없이 완전한 슬라이드를 얻을 수 있습니다.
이는 데이터 세트가 시간이 지남에 따라 증가할 때 특히 유용하며, 두 함수 모두 새 행이 추가될 때 동적으로 조정됩니다.
TAKE 및 SORT 함수를 사용하여 자체 업데이트되는 "최적 N개" 목록을 생성합니다.
데이터가 변경될 때마다 목록이 자동으로 업데이트됩니다.
바로 이 지점에서 TAKE 함수의 중요성이 드러납니다. TAKE 함수를 SORT 함수와 결합하면 데이터 세트에서 항상 가장 높은(또는 가장 낮은) 값을 표시하는 목록을 만들 수 있으며, 데이터가 변경될 때마다 자동으로 업데이트됩니다.
다시 매출 데이터를 예로 들어, 매출액 기준으로 가장 수익성이 높은 거래 5건 목록을 만들고 싶다고 가정해 보겠습니다. 공식은 다음과 같습니다.
=TAKE(SORT(A2:J20, 7, -1), 5)
SORT 함수는 19개 행 전체를 7번째 열(매출액)을 기준으로 내림차순으로 정렬하고, TAKE 함수는 정렬된 결과에서 상위 5개 항목을 가져옵니다. 각 항목에 대해 날짜, 지역, 영업 담당자 등 모든 정보가 포함된 전체 행을 가져오므로 컨텍스트가 그대로 유지됩니다. SORT 함수에 익숙하지 않다면, 관련 가이드를 참조하세요. 엑셀에서 데이터 정렬하기 기본 사항을 다루고 있습니다.
가장 좋은 점은 새로운 판매 데이터가 추가될 때 발생하는 현상입니다. 더 높은 판매 수치를 가진 행이 추가되면 자동으로 상위 5위권에 진입합니다. 만약... 원본 범위를 Excel 스프레드시트로 변환작동 범위는 자동으로 확장되어 전체 설정이 완전히 자동화됩니다.
DROP 및 COUNTA 함수를 사용하여 동적인 "최신 항목" 목록을 생성합니다.
항상 최신 제품들을 선보입니다
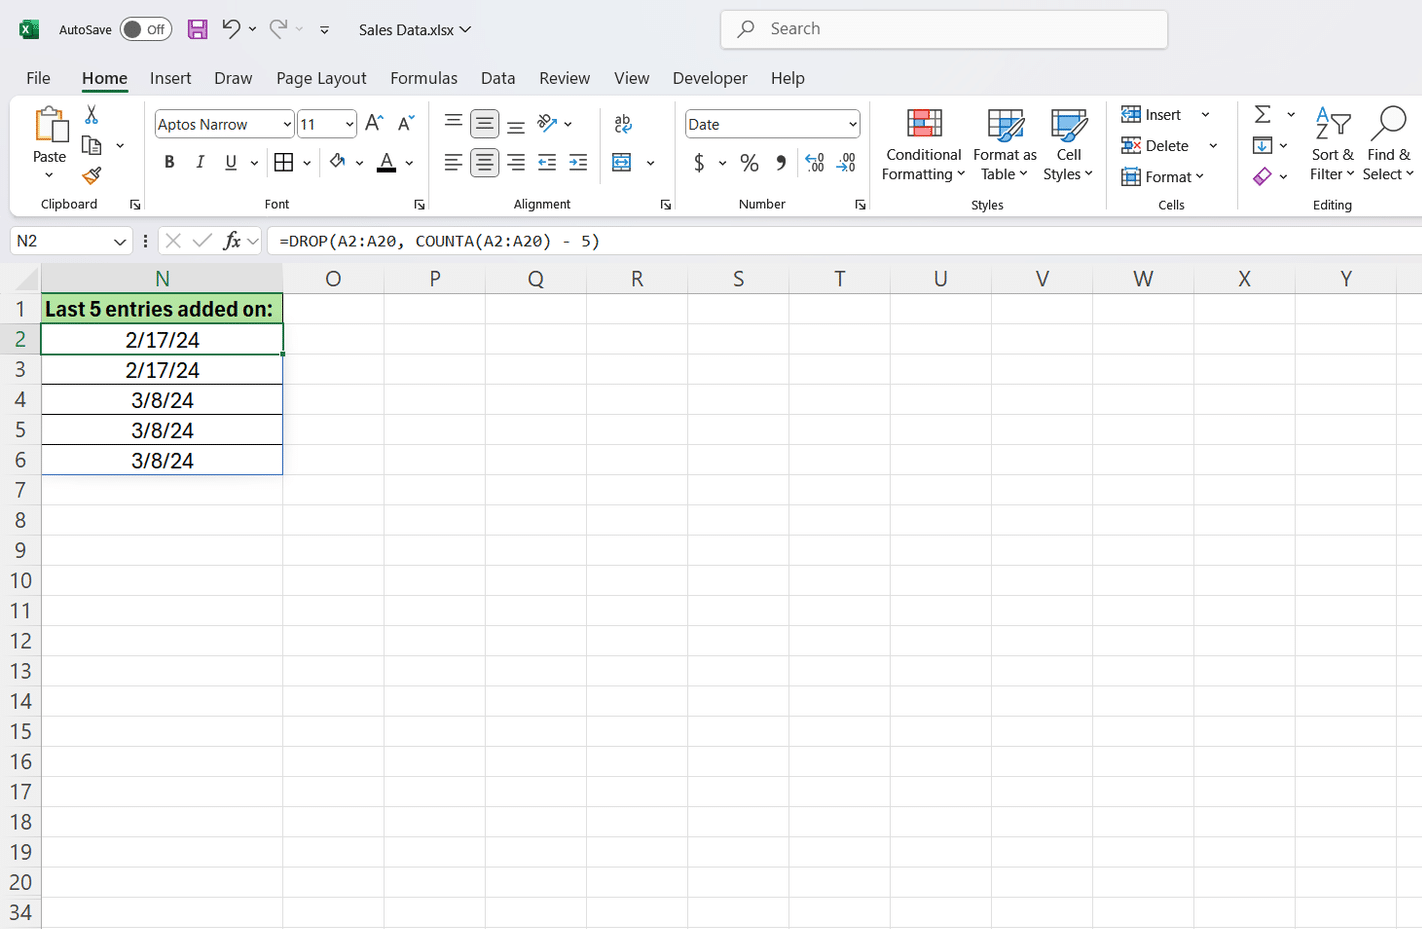
"상위 N개" 목록은 유용하지만, 때로는 데이터 세트에 가장 최근에 추가된 항목만 보고 싶을 때가 있습니다. DROP 함수와 COUNTA 함수를 함께 사용하면 이러한 경우에 효과적입니다. 행 수를 세고 마지막 몇 개를 제외한 모든 행을 삭제합니다.
판매 데이터를 사용하여 항상 최근 5개 항목을 표시하는 방법은 다음과 같습니다.
=DROP(A2:A20, 카운트A(A2:A20) - 5)
COUNTA 함수는 A열에 채워진 모든 셀의 개수를 세는데, 이 경우 19개입니다. 여기서 5를 빼면 DROP 함수는 14가 되므로, 처음 14개 행을 제거하고 나머지 5개 행을 반환합니다. 현재로서는 이 5개 행은 마이크 윌슨과 같은 영업 사원들이 톰 로드리게스에게 보낸 3월 거래 내역일 것입니다.
4월에 대한 새 행을 추가하면 COUNTA 값은 20으로 증가하고 DROP 값은 15로 조정되며 출력은 마지막 5개 항목을 표시하도록 변경됩니다. 다음 수식을 사용해도 동일한 결과를 얻을 수 있지만, 범위가 고정되어 있지 않은 경우 DROP과 COUNTA를 사용하는 방법이 더 유연합니다.
=TAKE(A2:A20, -5)
TAKE 및 DROP 기능은 다른 기능과 함께 사용할 때 가장 효과적입니다.
이 조합들은 나중에 시도해 보세요
TAKE 함수와 SORT 함수를 함께 사용하거나 DROP 함수와 COUNTA 함수를 함께 사용하는 것은 본 적이 있지만, 더 다양한 활용법이 있습니다. TAKE 함수 안에 FILTER 함수를 포함시키면 예를 들어 3000달러 이상의 전자제품 판매액을 특정 숫자로 정렬하여 표시하는 목록을 만들 수 있습니다. 또는 DROP 함수와 UNIQUE 함수를 함께 사용하여 여러 시트의 데이터를 병합할 때 중복된 헤더를 제거할 수 있습니다. CHOOSECOLS 함수와 TAKE 함수를 조합하면 대규모 데이터 세트에서 중요한 열만 남길 수도 있습니다. 이러한 함수들을 중첩해서 사용하면 매우 실용적인 조합을 만들 수 있습니다.