Excel에서 데이터 작업을 할 때 일부 작업은 불필요하게 지루하게 느껴질 수 있습니다. 예를 들어, 전체 이름 열을 성과 이름별로 분리하거나, 여러 셀의 텍스트를 특정 쉼표로 묶어야 할 수 있습니다. 이러한 작업은 복잡한 분석 작업이 아니라, 정기적으로 발생하는 기본적인 데이터 처리 작업입니다.

다행히 Excel에는 이러한 상황을 위해 특별히 설계된 기본 함수가 있습니다. 하지만 이러한 함수는 Excel의 일부가 아니기 때문에 간과되는 경우가 많습니다. 대부분의 사람들이 배우는 표준 Excel 도구 세트저를 포함해서요. 여기서 다룰 함수들은 고급 계산에 관한 것은 아니지만, 반복적인 데이터 작업을 한다면 이 함수들이 시간을 절약해 줄 수 있습니다.
로압 스리유에스
5. 텍스트 분할
함께 붙어 있는 텍스트를 분리합니다.

누군가 성과 이름, 심지어 중간 이름 이니셜까지 하나의 셀에 꽉 채워 넣은 스프레드시트를 받아본 적이 있다면, 그 데이터를 분리하는 것이 얼마나 어려운지 잘 아실 겁니다. TextSplit은 바로 이 문제를 해결해 줍니다. 단일 셀의 텍스트를 사용자가 지정한 구분 기호를 기준으로 여러 열로 분할해 줍니다.
샘플 영업 스프레드시트를 사용해 보겠습니다. 영업 담당자의 이름이 "Sarah Chen", "Mike Johnson", "Lisa Park"로 모두 한 열에 나열되어 있습니다. 각 이름을 별도의 열에 직접 입력하는 대신, TextSplit이 자동으로 작업을 처리해 줍니다.
공식은 다음과 같습니다.
=TEXTSPLIT(text, col_delimiter, [row_delimiter], [ignore_empty], [match_mode], [pad_with])
각 교사가 하는 일은 다음과 같습니다.
- 본문: 분할하려는 텍스트가 포함된 셀입니다.
- 열 구분 기호: 데이터를 구분하는 문자(공백, 쉼표, 세미콜론 등)입니다.
- 행 구분 기호(선택 사항): 행과 열로 나눌 때 사용됩니다.
- ignore_empty (선택 사항): TRUE는 빈 값을 무시하고, FALSE는 빈 값을 유지합니다(기본값은 FALSE입니다).
- match_mode(선택 사항): 대소문자 구분을 제어합니다(0은 대소문자 구분, 1은 대소문자 구분 안 함).
- pad_with (선택 사항): 결과의 길이가 다를 때 빈 셀을 무엇으로 채워야 합니까?
예를 들어 영업 담당자 이름의 경우 다음 공식을 사용하여 이름을 별도의 열로 나눕니다.
=TEXTSPLIT(A2, " ")
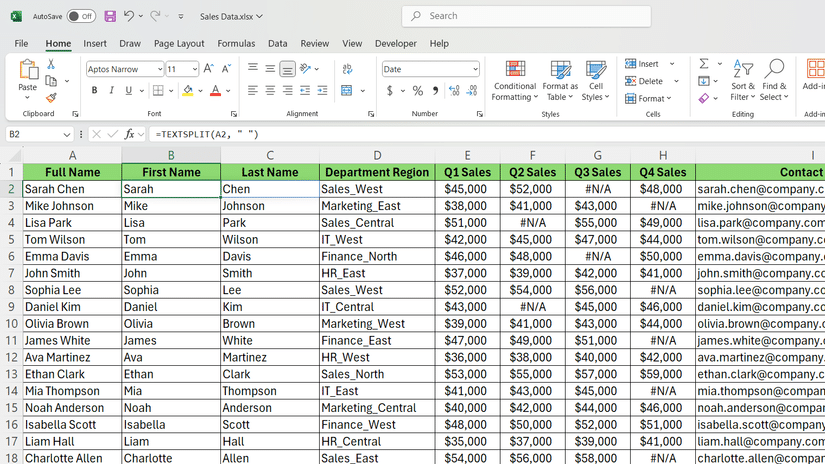
이 함수는 데이터를 기반으로 필요한 개수의 열을 자동으로 생성합니다. 이 기본적인 접근 방식은 대부분의 경우에 효과적이지만, 세부적인 제어를 제공하는 추가 매개변수도 있습니다. Excel의 TEXTSPLIT 함수.



4. 텍스트 조인
여러 셀을 하나의 셀로 병합
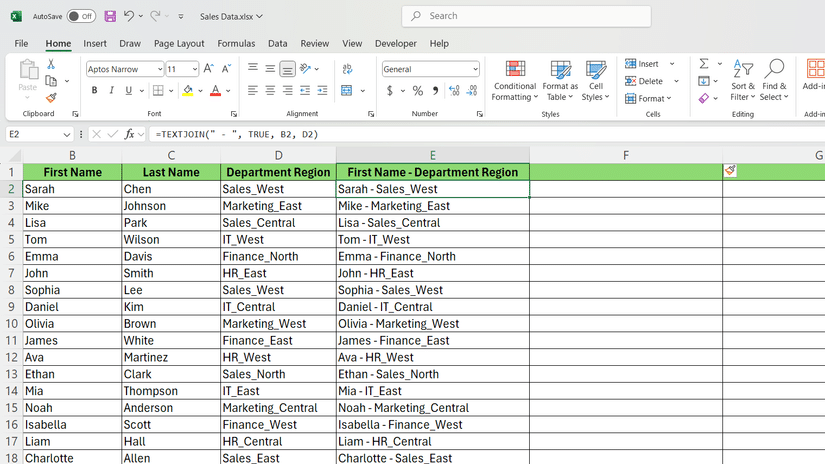
TEXTJOIN은 TEXTSPLIT과 반대되는 기능을 합니다. 여러 셀의 텍스트를 가져와 사용자가 선택한 구분 기호를 사용하여 단일 셀로 합칩니다. 전체 주소, 제품 설명 또는 이메일 목록과 같이 순차적인 값을 만들어야 할 때 유용합니다.
수식은 다음과 같습니다.
=TEXTJOIN(delimiter, ignore_empty, text1, [text2], ...)
각 매개변수가 제어하는 내용은 다음과 같습니다.
- 구분 기호: 포함된 값을 구분하는 문자 또는 텍스트(쉼표, 공백, 대시 등).
- 무시_빈: 빈 셀을 무시하려면 TRUE를 설정하고, 결과에 포함하려면 FALSE를 설정합니다.
- text1, text2 등: 병합하려는 셀이나 범위(개별 셀이나 전체 범위를 지정할 수 있음).
판매 스프레드시트를 살펴보면, 이름과 지역에 대한 별도의 열이 있지만 이를 결합한 하나의 열이 필요한 경우 TEXTJOIN을 사용합니다. 무시_빈 TRUE로 설정하면 빈 셀은 자동으로 건너뜁니다.
=TEXTJOIN(" - ", TRUE, B2, D2)다양한 텍스트 통합 방법 중에서 선택할 때 이해 CONCAT와 TEXTJOIN 함수의 차이점 이는 특정 데이터 통합 요구 사항에 맞는 올바른 도구를 선택하는 데 도움이 될 수 있습니다.
3. 선택
데이터의 특정 열을 지정하세요.
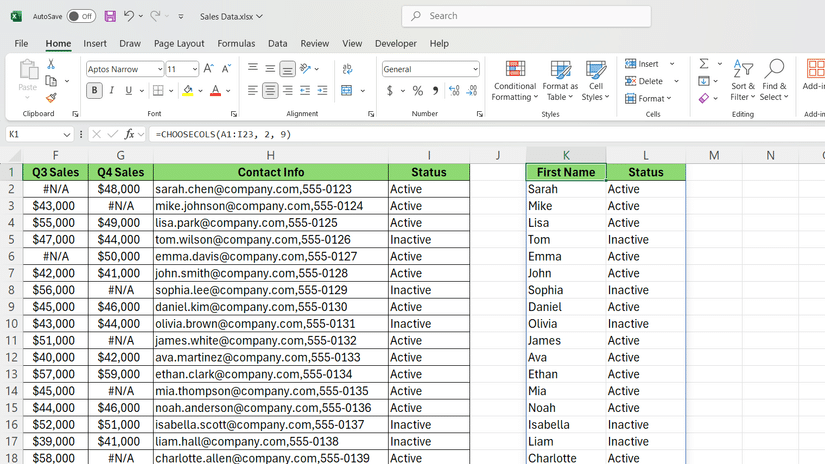
CHOOSECOLS를 사용하면 복사하여 붙여넣거나 참조를 생성하지 않고도 범위에서 특정 열을 추출할 수 있습니다. 대용량 데이터 세트가 있지만 분석에 2, 5, 8번 열만 필요한 경우, 이 함수는 필요한 열만 가져오고 나머지는 삭제합니다.
판매 데이터를 기반으로 주문 날짜, 제품 카테고리 및 기타 세부 정보를 무시하고 영업 사원과 영업 사원 이름만 추출하고 싶을 수 있습니다. CHOOSECOLS 함수는 열을 수동으로 선택하고 복사하는 대신, 원본 데이터가 변경되면 자동으로 업데이트되는 동적 참조를 생성합니다.
이 함수는 다음 공식을 따릅니다.
=CHOOSECOLS(array, col_num1, [col_num2], ...)
각 매개변수의 작동 방식은 다음과 같습니다.
- 정렬: 원본 데이터가 포함된 범위 또는 표(예: A1:F100 또는 표 참조)입니다.
- 열_번호1: 추출하려는 첫 번째 열의 번호(첫 번째 열은 1, 두 번째 열은 2 등)
- col_num2 등: 포함하고 싶은 추가 열 번호(선택 사항 - 원하는 만큼 지정할 수 있음).
예를 들어, 열 2에서 영업 담당자의 이름을 추출하고 열 9에서 영업 담당자의 상태를 추출하려면 다음을 사용합니다.
=CHOOSECOLS(A1:I23, 2, 9)
이 함수는 두 열을 모두 스트리밍 배열로 반환하며, 데이터에 맞게 크기가 자동으로 조정됩니다. CHOOSECOLS는 이러한 이유로 많은 시간을 절약할 수 있는 Excel 함수대용량 데이터 세트로 작업할 때 여러 개의 VLOOKUP 수식을 사용하거나 열을 수동으로 복사할 필요가 없습니다.
Excel에도 CHOOSEROWS 함수가 있는데, 이 함수는 비슷하게 작동하지만 행 번호가 있는 동일한 수식 구조를 사용하여 열 대신 특정 행을 선택합니다.
2. 가져가서 버리세요
데이터의 일부 추출
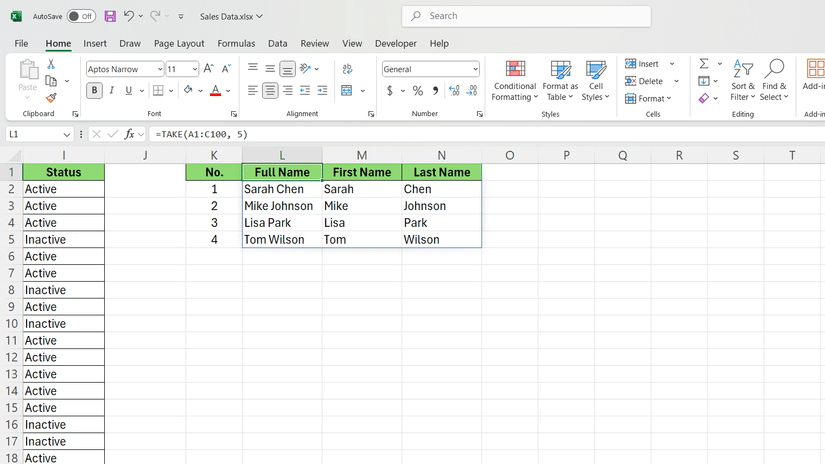
TAKE와 DROP은 데이터 범위의 특정 부분을 추출하는 데 사용됩니다. TAKE는 데이터 세트의 시작이나 끝에서 특정 개수의 행이나 열을 추출하는 반면, DROP은 시작이나 끝의 행이나 열을 제거하고 남은 부분만 남깁니다.
이러한 함수는 데이터 샘플링을 위한 정밀한 도구 역할을 합니다. 빠른 분석을 위해 처음 10개 행의 데이터만 필요하든, 계산을 방해하는 헤더 행을 제거하든, 이 함수는 작업을 깔끔하게 처리합니다.
TAKE는 다음 공식을 사용합니다.
=TAKE(배열, 행, [열])
DROP은 비슷한 패턴을 따릅니다.
=DROP(배열, 행, [열])
두 함수의 매개변수 작동 방식은 다음과 같습니다.
- 정렬: 추출하거나 수정하려는 원본 데이터 범위입니다.
- 행: 가져올/삭제할 행의 수(양수는 위에서부터, 음수는 아래에서부터)입니다.
- 열(선택 사항):
가져오거나 삭제할 열의 개수(왼쪽부터 양수, 오른쪽부터 음수).
판매 데이터의 처음 5개 행을 가져오려면 다음 공식을 사용하세요.
=TAKE(A1:C100, 5)
처음 20개 행을 제거하고 깨끗한 데이터로 작업하려면 다음을 시도해 보세요.
=DROP(A1:C23, 20)
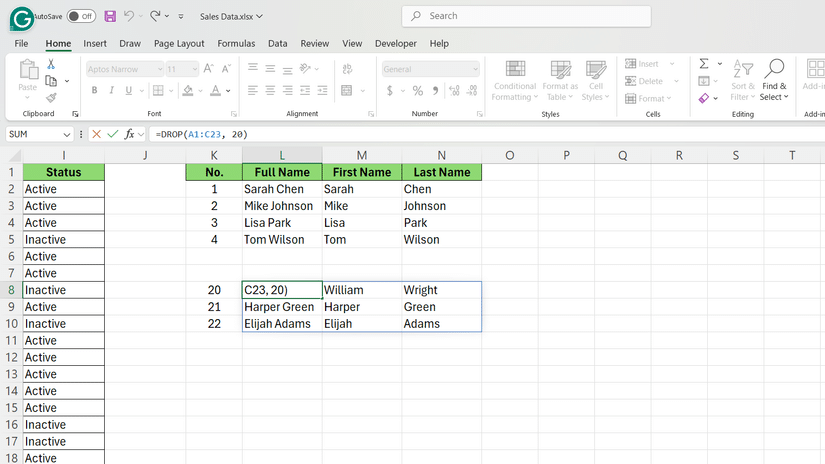
행과 열 연산을 결합할 수 있습니다. 예를 들어, 다음 수식은 처음 10개의 행과 처음 3개의 열을 제공합니다.
=TAKE(A1:F23, 10, 3)
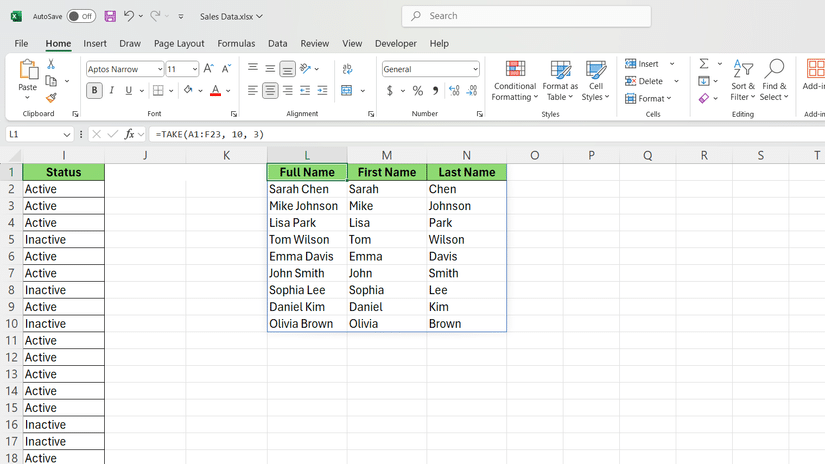
이러한 기능은 특히 자동으로 조정되는 동적 데이터 하위 집합이 필요할 때 매우 유용합니다. 알아보기 Excel에서 TAKE 및 DROP 함수를 사용하는 방법 변화하는 데이터 세트 크기에 맞춰 조정되는 유연한 보고서를 만들 수 있는 가능성이 열립니다.
1. 골재
복잡한 데이터를 처리하는 강력한 계산
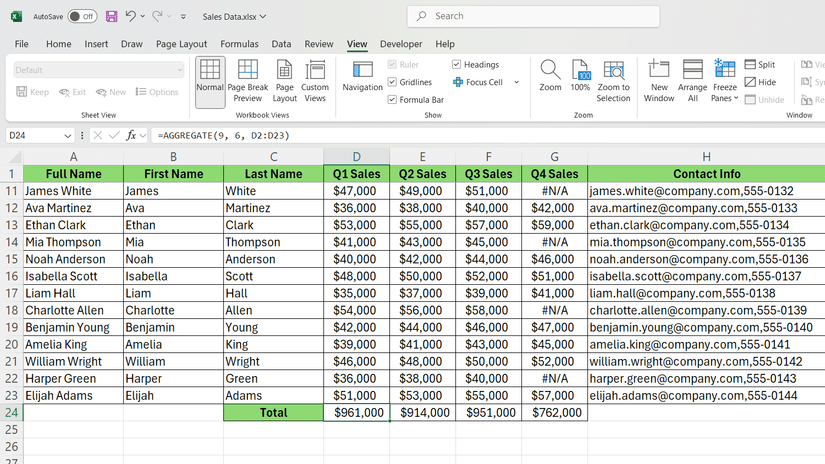
AGGREGATE는 19가지 다양한 통계 함수의 기능을 하나의 유연한 수식으로 결합합니다. 가장 큰 특징은 오류, 숨겨진 행 또는 필터링된 데이터를 무시할 수 있다는 점인데, 이는 SUM이나 AVERAGE와 같은 표준 함수로는 안정적으로 수행할 수 없는 기능입니다.
데이터에 #N/A 오류가 있거나 특정 지역만 표시하도록 필터링한 경우, AGGREGATE는 이러한 문제 없이 결과에 영향을 주지 않고 합계, 평균 또는 기타 통계를 계산할 수 있습니다. 가시성과 데이터 품질이 자주 변경되는 동적 데이터 세트를 다룰 때 이 기능이 매우 유용합니다.
문장 구조에는 여러 구성 요소가 포함되어 있습니다.
=AGGREGATE(function_num, options, array, [k])
각 기준은 계산의 다양한 측면을 제어합니다.
- 함수_번호: 사용할 함수를 지정하는 1~19의 숫자(1=평균, 4=최대, 9=합계, 12=중간값 등).
- 옵션 : 계산 중 무시할 항목을 제어합니다(0=없음, 1=숨겨진 행, 2=오류 값, 3=숨겨진 행 및 오류, 5=오류 값만, 6=숨겨진 행 및 오류 값).
- 정렬: 계산할 셀 범위입니다.
- k (선택 사항):
- LARGE, SMALL, PERCENTILE 등 특정 함수에서만 사용됩니다.
오류를 무시하고 표시된 판매 금액을 요약하려면 다음을 사용할 수 있습니다.
=AGGREGATE(9, 6, D2:D23)
숫자 9는 SUM을 지정하고, 숫자 6은 함수에 숨겨진 행과 오류 값을 모두 무시하도록 지시합니다.
계산을 수행하는 강력한 능력이 바로 AGGREGATE가 포함된 이유입니다. 모든 직장인이 알아야 할 엑셀 함수 목록—간단한 기능으로는 효과적으로 관리할 수 없는 실제 데이터의 혼란을 처리합니다.
사용할 만한 내장 도구
가장 중요한 Excel 함수는 사람들이 가장 먼저 배우는 함수가 아닌 경우가 많습니다. 하지만 이러한 함수는 복잡한 텍스트 데이터 처리, 대용량 데이터 집합에서 특정 부분 추출, 불완전한 데이터에 대한 계산 수행 등 실제 스프레드시트 작업에서 발생하는 미묘한 문제들을 해결합니다. 앞서 설명한 함수들은 고급 Excel 기술을 필요로 하지 않습니다. 하지만 TEXTSPLIT, CHOOSECOLS, TAKE, DROP은 Microsoft 365와 웹용 Excel에서만 사용할 수 있습니다.
다음에 데이터를 반복적으로 정리하거나 열을 수동으로 복사해야 할 때, 이러한 함수가 있다는 것을 기억하세요. Excel에 이미 내장되어 있어 지루한 작업을 처리할 수 있으므로, 데이터가 실제로 무엇을 의미하는지 파악하는 데 집중할 수 있습니다.